AI 产品竞品分析:技术底座、产品体验与商业生态
分析 AI 产品,功能清单要换成三层:技术底座决定能力上限,产品体验决定用户感知,商业生态决定能打多久。能力要测出来,成本要算到单次任务,结论要标注日期并持续更新。
目录 · 11 节
竞品分析三部曲 · 第二篇。第一篇讲通用方法论,本篇回答一个它没有覆盖的问题:当分析对象变成 AI 产品(大模型应用、AI Agent、AI 原生工具)时,分析框架要补充什么。第三篇讲如何用 AI 做竞品分析。
先看一个常见的尴尬场景。按传统方法分析两款 AI 写作工具:都有长文生成、改写润色、模板库,界面大同小异,定价也接近。对比表做完,结论是“功能趋同,建议跟进”。
这个结论几乎没有价值。两款功能列表相同的工具,一个底层用的是旗舰模型,另一个接的是廉价接口;一个会先追问需求、给出处,另一个错了只能整段重来。生成质量、响应速度、成本结构和用户留存天差地别,而这些差异在功能对比表里一个都看不见。
先说结论: AI 产品竞品分析的底层逻辑没有变,还是“明确自己的问题 → 拆解对手 → 得出对自己有用的结论”;变的是拆解对象。功能清单要换成三层:技术底座决定能力上限,产品体验决定用户感知,商业生态决定能打多久。落到操作上,有三件事最不一样:能力要测出来,成本要算到单次任务,结论要标注日期并持续更新。
一、为什么传统竞品分析方法不够用
传统产品分析和 AI 产品分析的差异,可以汇总成一张对照表。
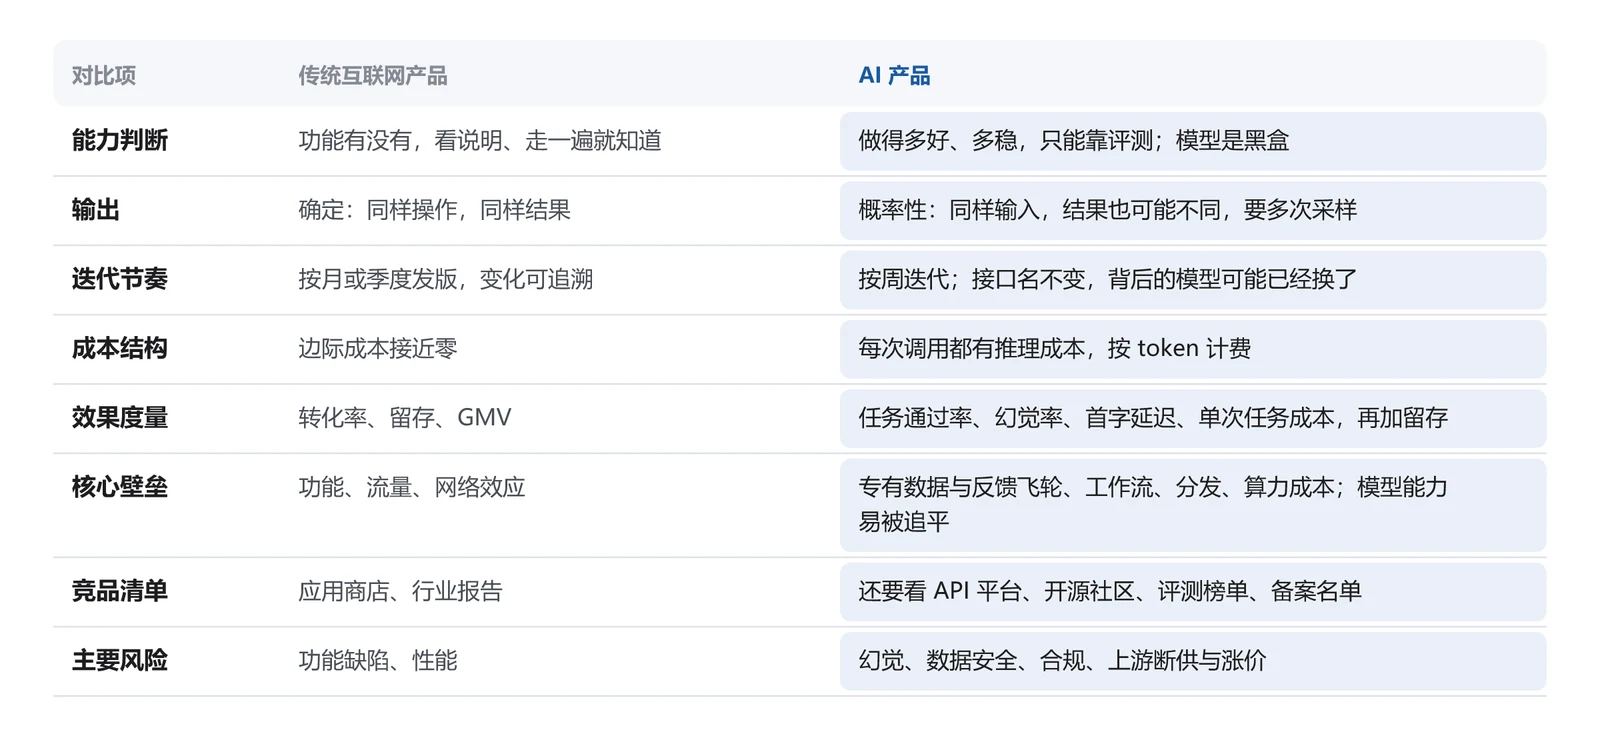
图 1 传统互联网产品与 AI 产品,竞品分析的关注点对照
这些差异背后,是 AI 产品四个特殊的性质。
第一,模型是黑盒。 中国信通院的魏凯有个很直白的说法:神经网络训练叫“涌现”,结果不确定,因为它本质是黑盒子,只有通过测试,才知道能力有没有达到[1]。这意味着你不能像分析传统软件那样,靠看介绍、看接口去推断能力,评测几乎是唯一的窗口。
第二,输出不确定。 同一个问题问两次,答案可能不同。同样叫“智能客服”,解决率可能是 80%,也可能是 30%。传统“走一遍、截个图”的方法不可复现,必须多次采样、统计通过率。
第三,周级迭代,还会静默升级。 换基座模型、调提示词、上线新能力都在高频发生。同一个产品名、同一个 API 接口背后的模型,可能几周内就换了。今天截图对比出的差距,下个月可能被抹平甚至反转。
第四,效果由四层共同决定。 模型底座(自研、开源微调或调用 API),提示词与系统设计,接入的数据(检索增强、联网搜索、专有知识库),以及工程层(延迟、并发、限流),缺任何一层都会误判。看到竞品“接了某个模型”,就以为大家能力相同,是产品侧最常见的误判。
二、AI 产品竞品分析的框架:三层结构
在第一篇“公司 · 产品 · 用户”的基础上,AI 产品需要向下多拆一层技术底座,向外多看一层成本与生态。整理成三层框架:
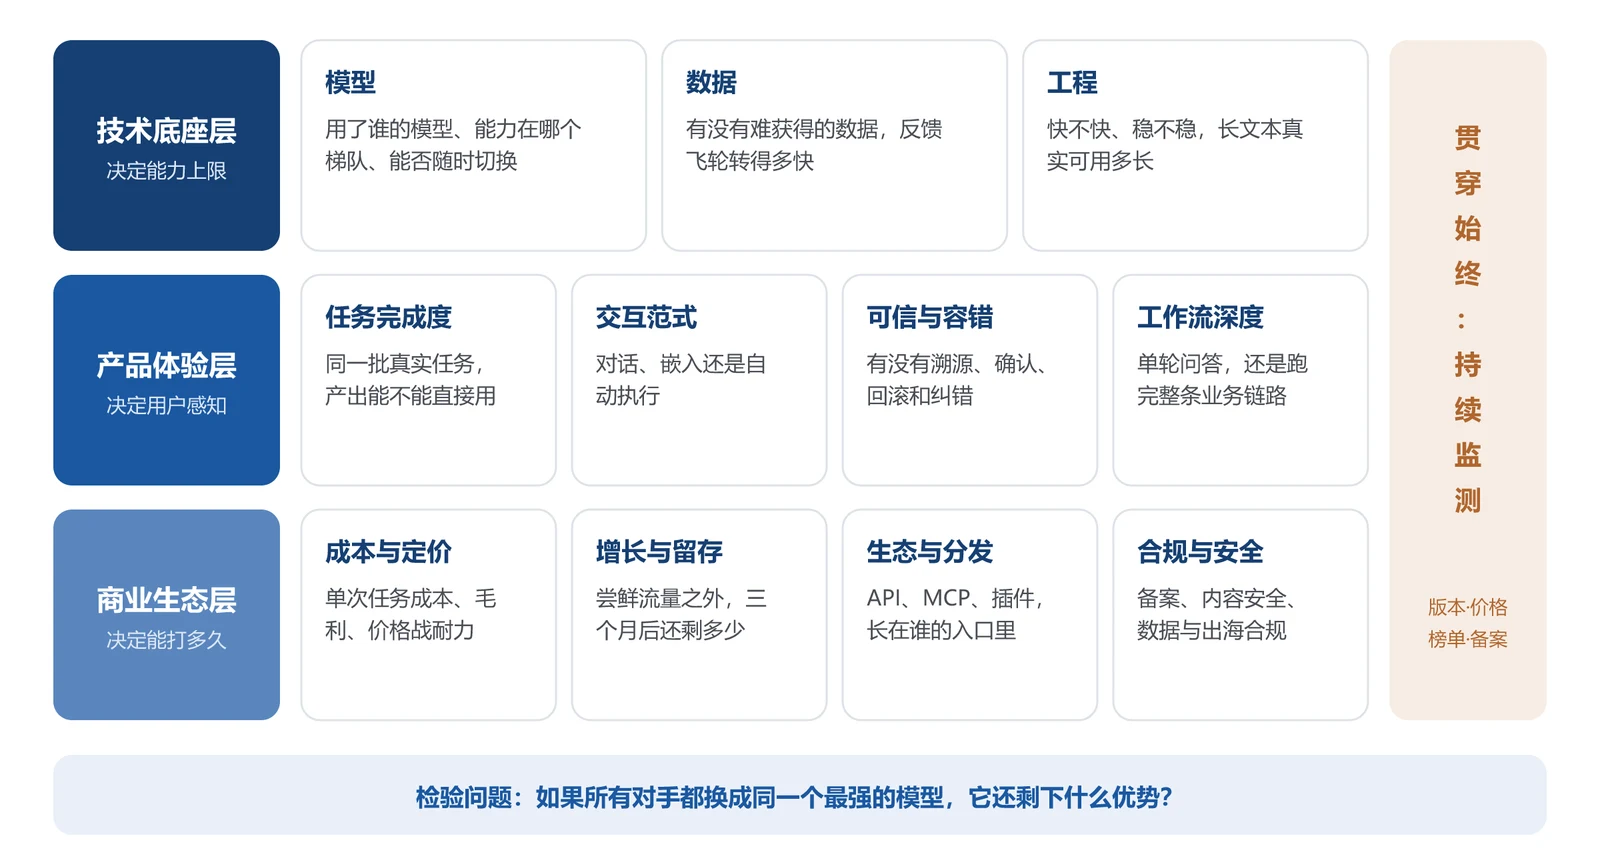
图 2 AI 产品竞品分析的三层框架。持续监测贯穿始终,换底座测试用来检验结论
三层的关系是:技术底座决定能做到多好,产品体验决定用户感受到多好,商业生态决定这种好能持续多久。框架底部那个检验问题,是整篇文章最重要的一句话,第六节会展开。
三、第一层 技术底座:决定能力上限
这是 AI 产品特有、也最容易被产品经理跳过的一层。不了解这一层,分析 AI 竞品时只能看到皮相。
(一)模型策略:自研、开源微调,还是调用 API
评估一个 AI 竞品,先弄清它的模型从哪来。三种策略各有代价,决定了它的能力天花板、成本结构和最大风险。
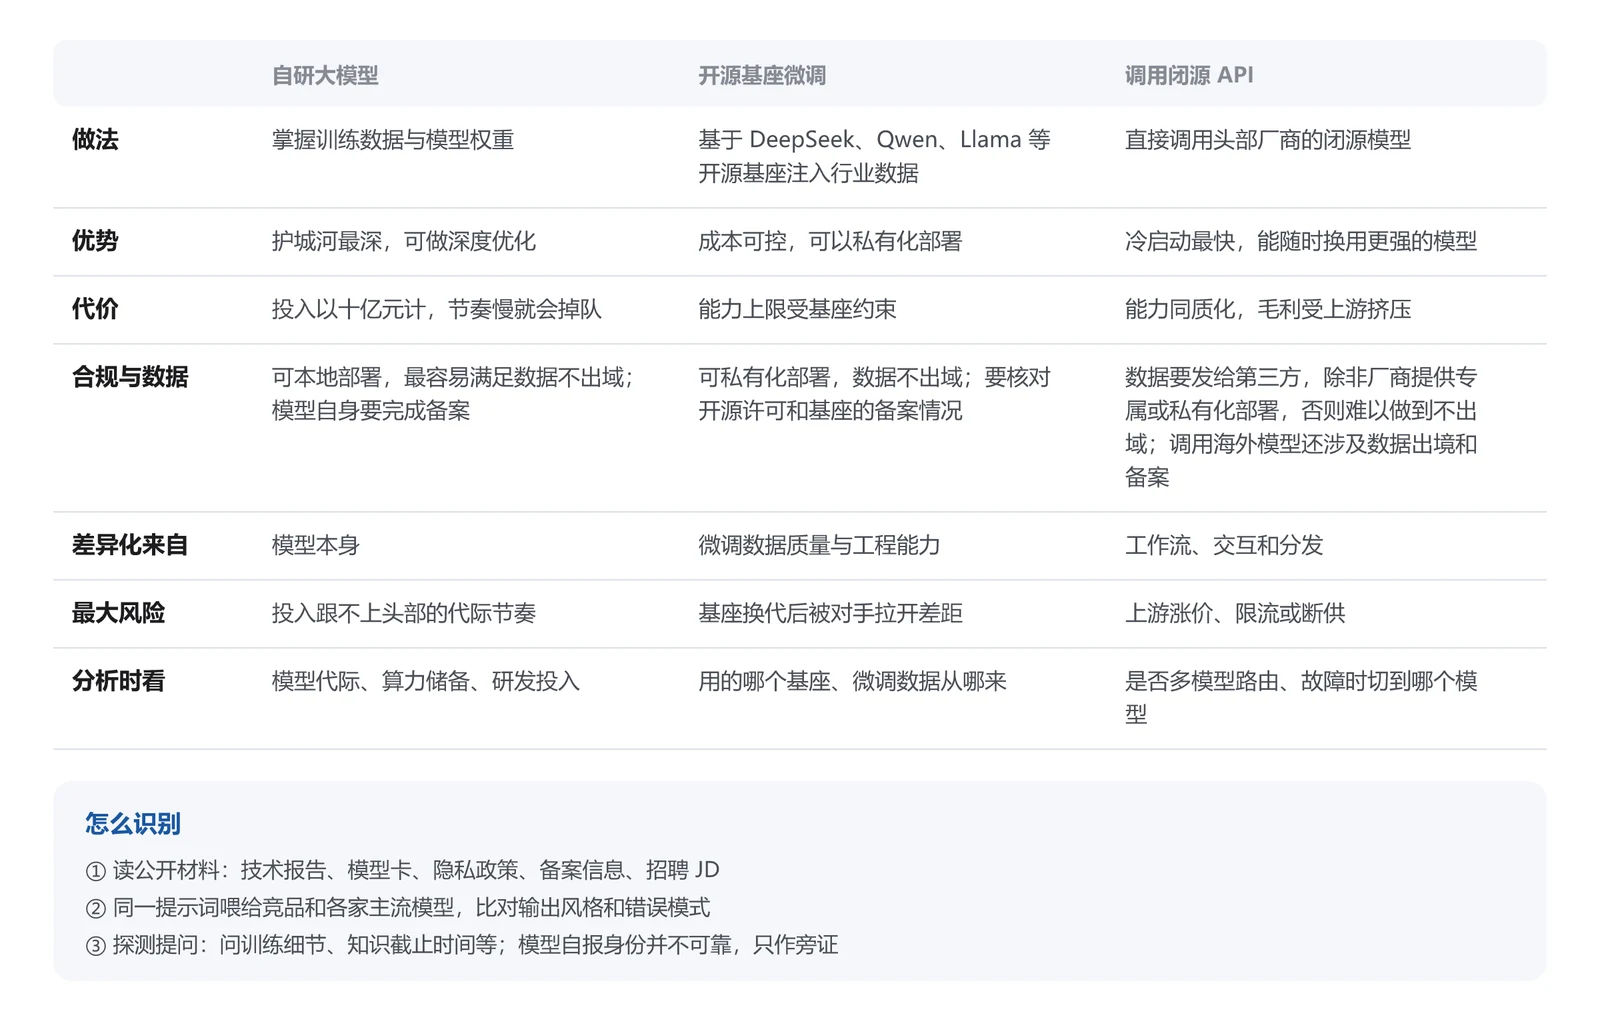
图 3 模型策略三派的对比与识别方法
识别方法有三种,可信度依次降低。最可靠的是读公开材料:技术报告、模型卡、隐私政策里列出的数据处理方、国内的生成式 AI 备案信息、招聘 JD。其次是横向比对:把同一提示词同时喂给竞品和各家主流模型,看输出风格和错误模式的相似度。最后是探测提问,问它的训练细节、知识截止时间。要注意,模型对“你是谁”的回答并不可靠,经常张冠李戴,只能作为旁证。
确认了模型来源,还要追问三件事:提示词和知识库是怎么设计的?故障时会切换到哪个备用模型?是否支持多模型路由?这三个答案决定了它真实的能力上限和成本结构。
(二)能力评测:公开榜单定梯队,自建评测做决策
模型能力不能只看厂商宣传。公开评测基准很多,各有测量范围和局限。
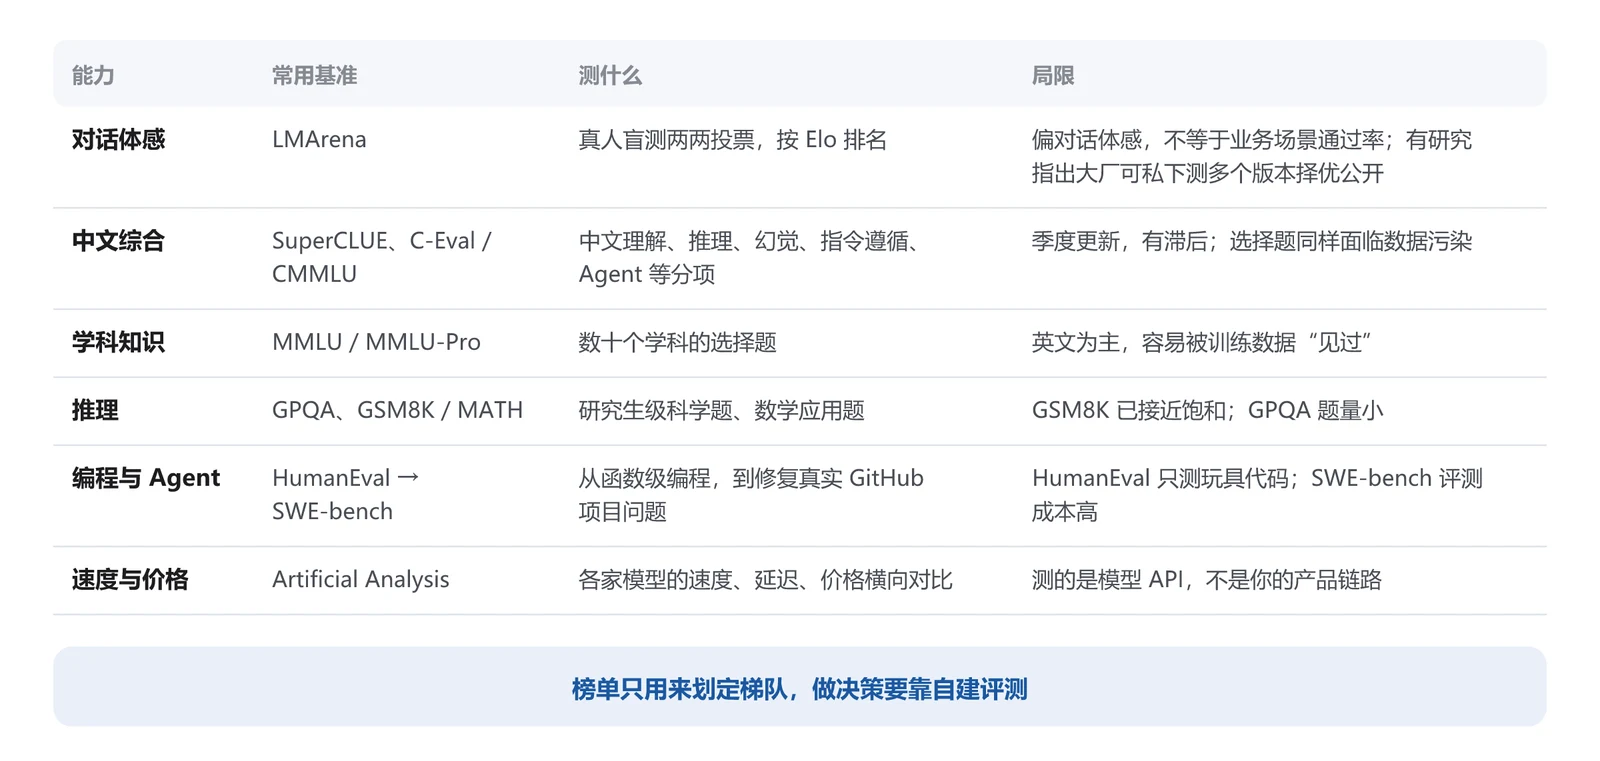
图 4 主流公开评测基准:测什么、局限是什么
给产品经理的结论很直接:榜单分数只用于快速定位梯队,不能用于决策。 原因有三。其一,公开题目普遍存在数据污染,训练时可能已经“见过”。其二,厂商会针对榜单优化,指标一旦成为目标就不再可靠。2025 年 4 月 Cohere 等机构的研究者发表《The Leaderboard Illusion》,指出 Chatbot Arena 存在大厂私下测试多个版本、择优公开的问题(LMArena 对部分结论提出了异议)[3]。其三,LMArena 反映的是对话体感,不是你的业务场景通过率[2]。另外,SuperCLUE 等中文榜单已经把数学推理、幻觉控制、指令遵循、Agent 任务规划拆成独立维度打分[4],这份维度表本身就是一个现成的评测框架参考。
决策要靠自建评测。不写评测代码的产品经理,也可以按下面的闭环做实测:
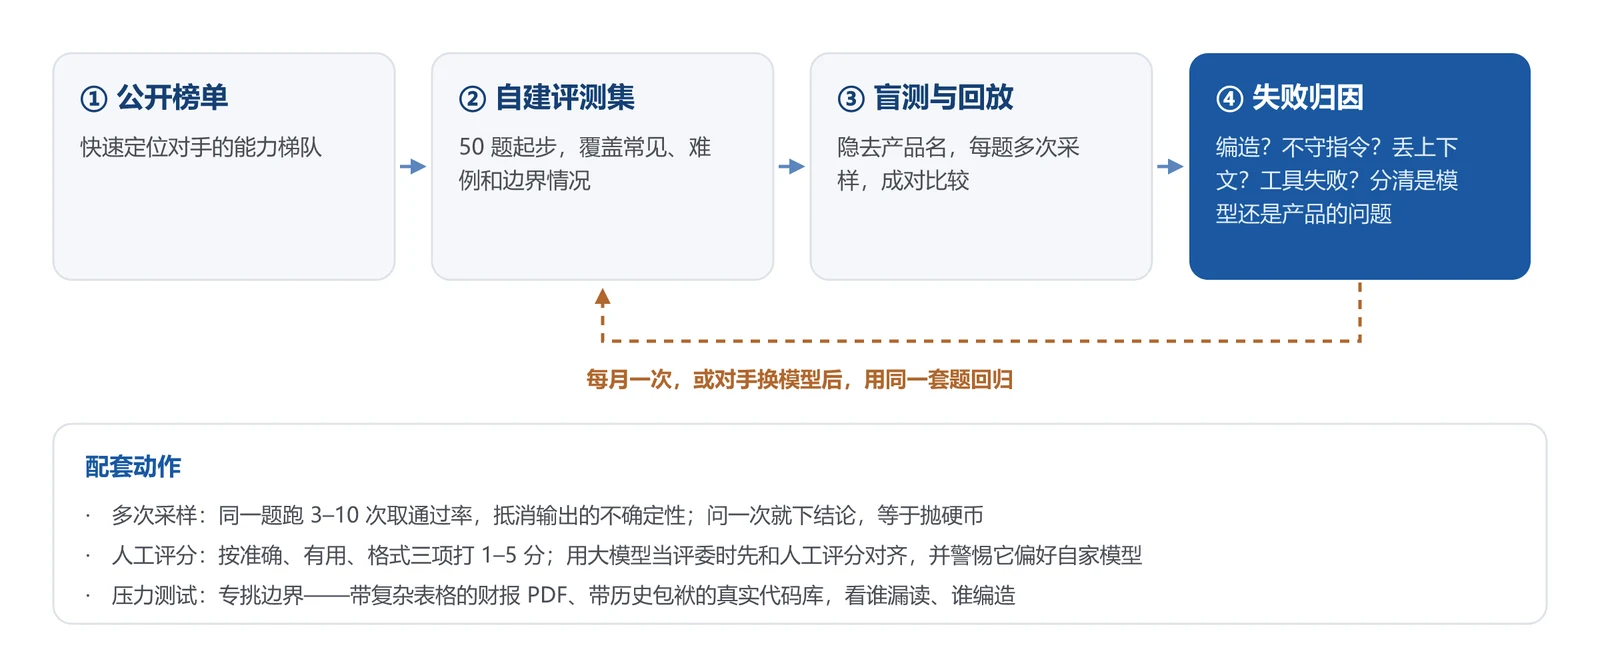
图 5 从公开榜单到自建评测的闭环。公开榜单只解决“定位”,自建评测加失败归因才解决“决策”
这里最容易被忽略的是“多次采样”:同一个问题跑一次就下结论,在 AI 产品上几乎等于抛硬币。题目数量上,50 题左右是务实的起点,覆盖常见任务、难例和边界情况;评审时隐去产品名,按准确、有用、格式分项打分[5]。用大模型当评委可以提效,但要先和人工评分对齐,并警惕它偏好与自己同源的模型。压力测试要专挑边界:分析 PDF 对话产品,就上传一份含复杂表格和多栏排版的财报,看谁漏读、谁编造;分析 AI 编程工具,就给它一个带历史包袱的真实代码库,看建议是否贴合项目上下文。
速度和价格的横向对比,可以先看 Artificial Analysis 这类第三方网站[6],但它测的是模型 API,不是竞品产品的完整链路,最终仍以你的实测为准。
(三)数据与飞轮:看不见的壁垒
公开语料已经被各家模型大量使用,未来的壁垒不在数据量,而在数据的独占性和反馈的动态性。用户对 AI 建议“接受、修改、拒绝”的每一次行为,都会成为下一轮对齐训练的燃料。业内一个常见的观察是,Agent 做得最好的团队,往往是把“发版 → 小流量 → 盯表现 → 改进”这个循环转得最快的团队[21]。
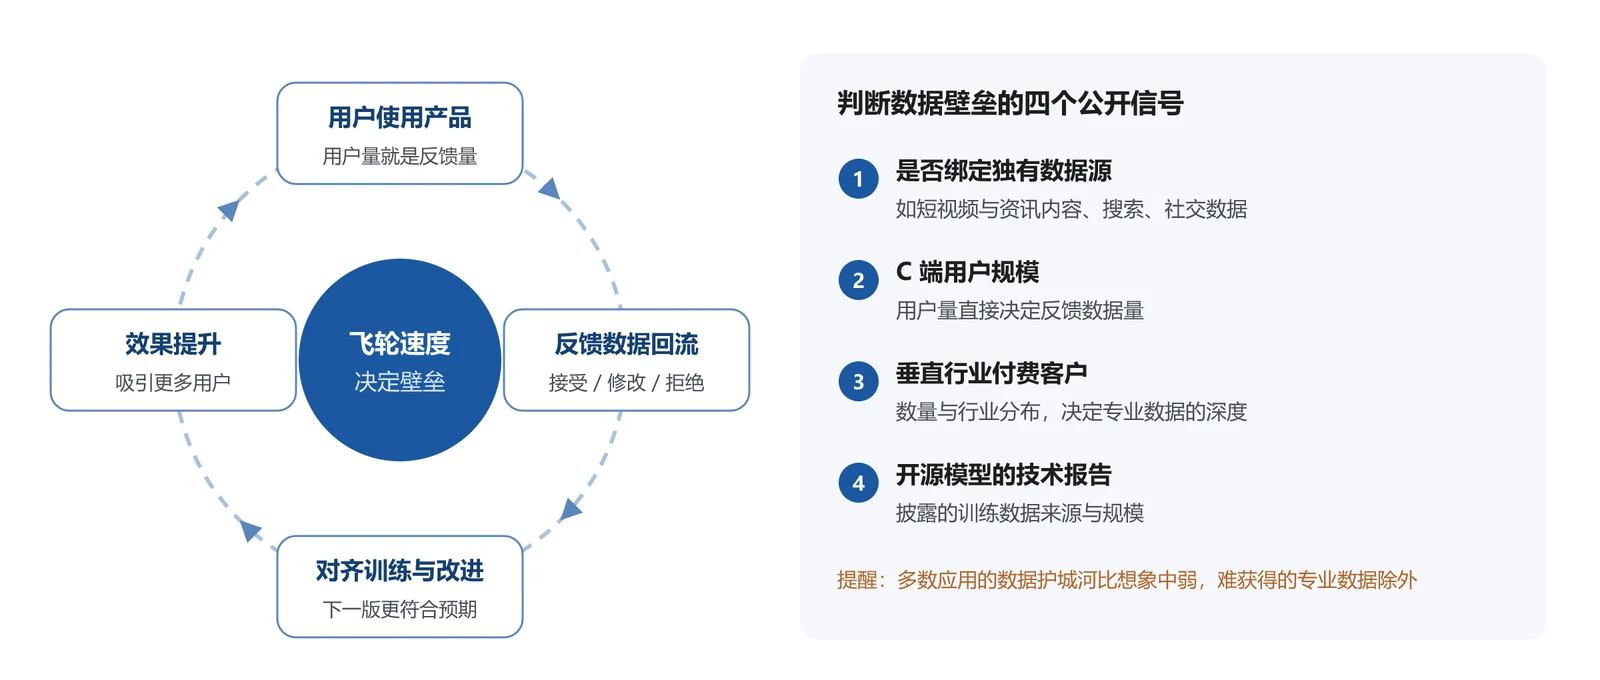
图 6 数据飞轮,以及判断竞品数据壁垒的四个公开信号
四个信号中,C 端用户规模最直观:用户量直接等于反馈数据量。据新浪财经援引的月活统计,2026 年 9 月豆包月活约 4.19 亿,居国内 AI 应用首位[23],这本身就是它最大的数据资产。但也要记住红杉资本 2023 年的提醒:多数应用公司产生的数据并不构成难以逾越的护城河,难以获得的专业领域数据除外[7]。
(四)工程指标:快不快、稳不稳
模型答得再对,如果要等 8 秒才出第一个字,用户依然会流失。工程指标在竞品分析中常被忽略,却直接决定 C 端体验和 B 端成本。
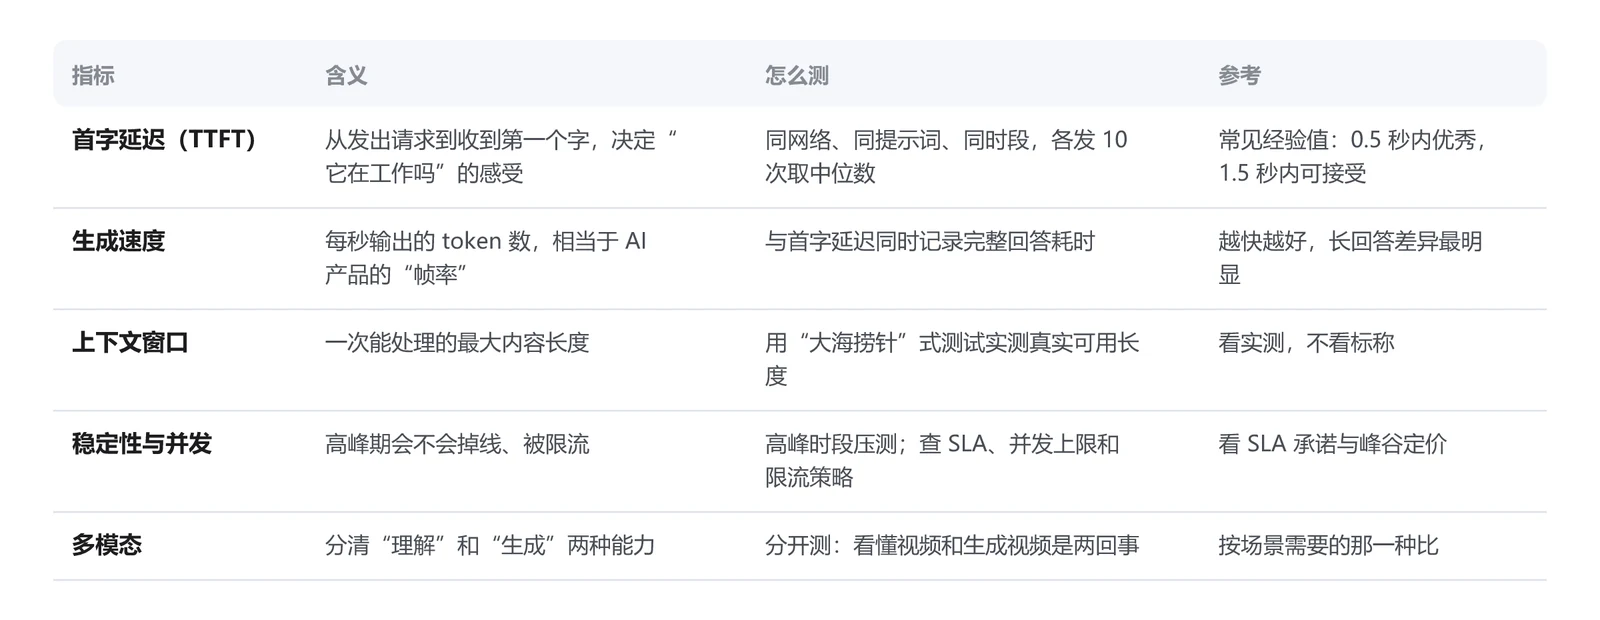
图 7 工程指标的含义、测法与参考值
测法并不复杂:同一网络、同一提示词、同一时段,对每个竞品各发 10 次请求,记录首字延迟和完整回答耗时,取中位数[22]。上下文窗口一定要实测,标称 100 万 token,不代表 100 万 token 内的信息都能被准确找回。
四、第二层 产品体验:决定用户感知
技术底座决定上限,产品体验决定用户实际感知到的价值。同一个模型,做成产品后的体验可以天差地别。
(一)任务完成度:对比单位从功能换成任务
这一层的对比单位不再是功能点,而是任务:同样让它写一份周报,产出能不能直接交差,需要人工修补多少。第一篇介绍的任务评分表在这里同样适用,只是每个任务都要多次采样。
(二)交互范式:对话、嵌入,还是自动执行
主流的交互范式有三种,AI 的自主程度依次升高。
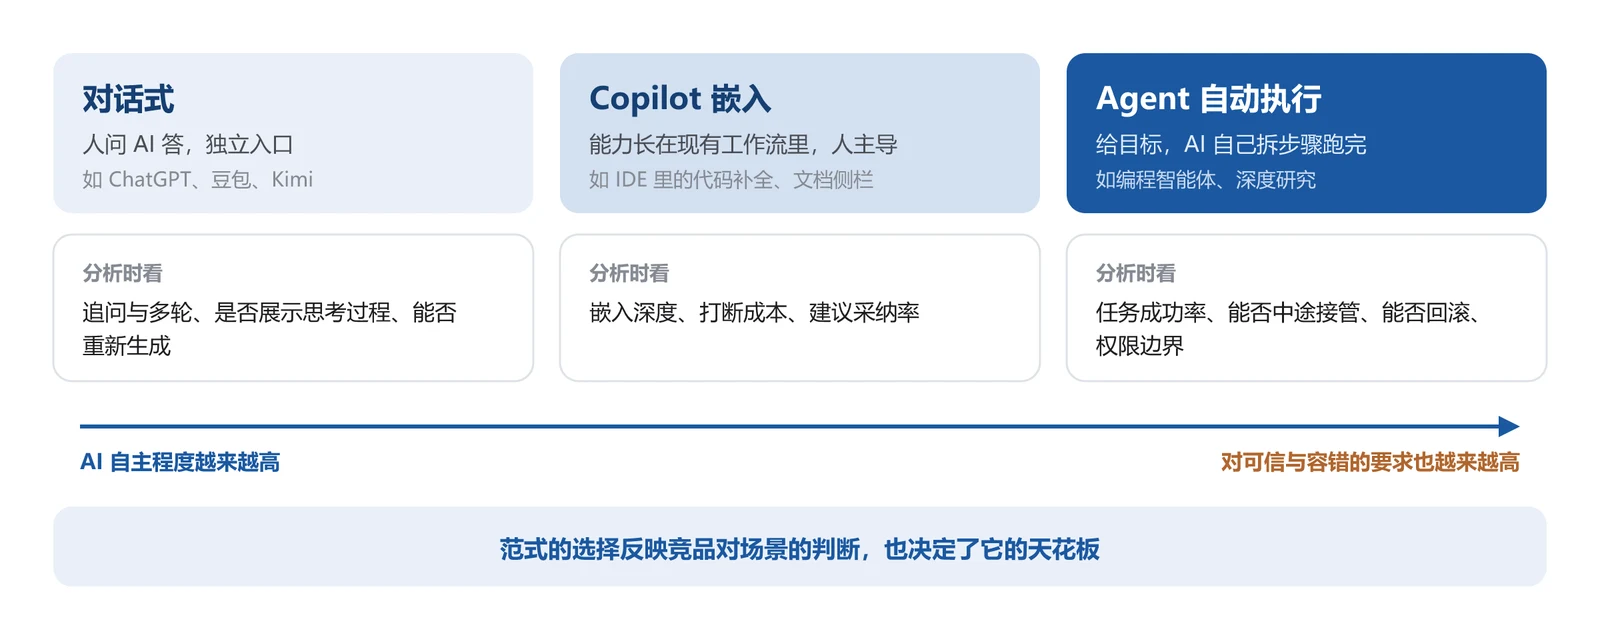
图 8 三种交互范式,以及每种范式分析时要看什么
范式的选择本身就是竞品的战略判断。同样做编程,独立对话入口、编辑器内嵌补全、后台自动执行任务的智能体,面对的用户、打断成本和天花板完全不同。行业的主线正在从 Copilot 走向 Agent,越往右,对可信和容错的要求越高。
(三)可信与容错:留存差距的主要来源
AI 一定会犯错,产品功力体现在怎么兜底。分析竞品时,逐项检查这五件事:
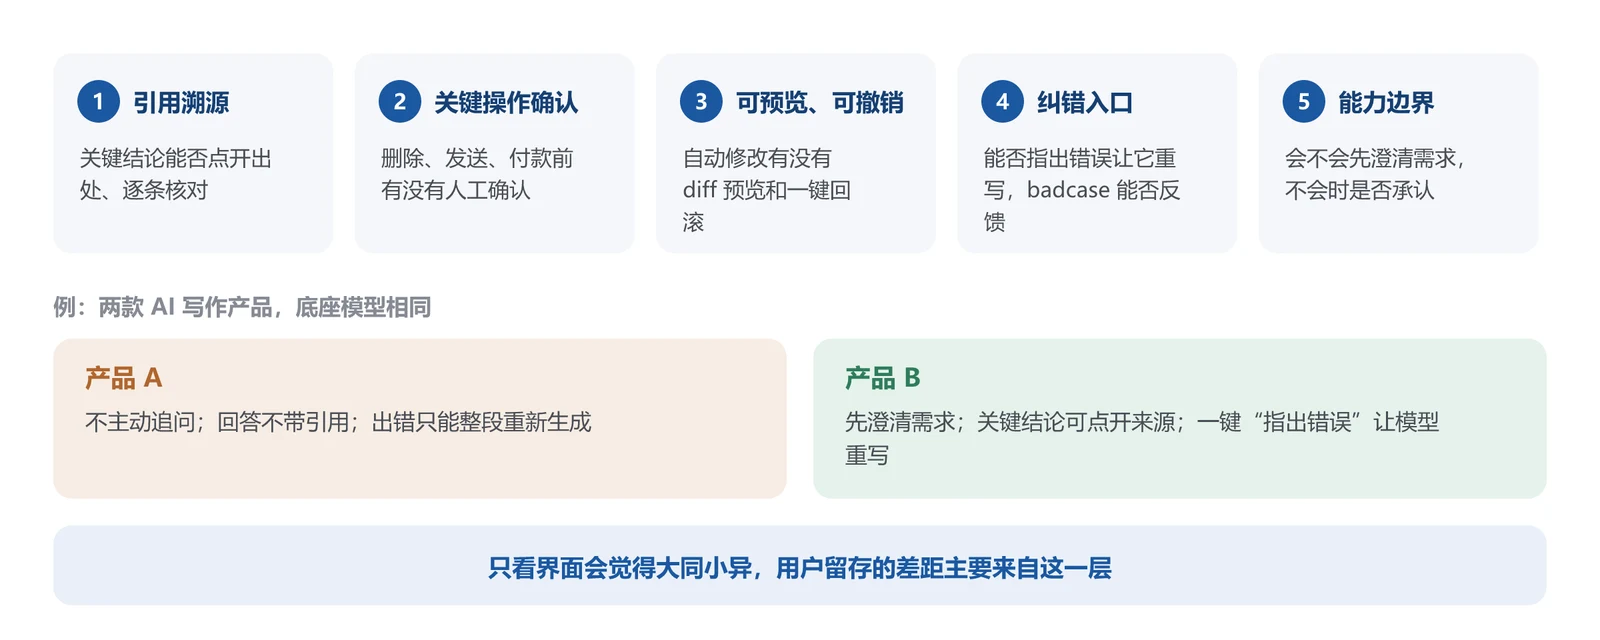
图 9 可信与容错五项检查。底座相同的两款产品,差距常常就在这一层
系统提示词决定了产品的“人格”和能力边界:开场白是什么,会不会主动澄清需求,格式约束能力如何,不会时会不会硬编。这些细节不出现在功能列表里,却直接决定用户愿不愿意继续用。一个没有任何容错设计的 AI 产品,要么团队不成熟,要么场景无关紧要。
(四)工作流深度:从聊天工具到干活工具
单轮问答谁都能做,能跑完整条业务链路的产品才有壁垒。同样是 AI 面试工具,“聊几句给点反馈”和“导入 JD → 生成题库 → 视频面试 → 多维评估 → 输出报告 → 写入招聘系统”是两个物种。分析时把竞品覆盖的链路画出来,看它在哪一步断掉、断掉之后用户要切到哪个工具,断点往往就是机会。多端覆盖也属于这一层:App、网页、桌面客户端、浏览器插件、IDE 插件,长在用户已有工作流里的入口越多,切换成本越高。
五、第三层 商业生态:决定能打多久
(一)成本与定价:换算成单次任务成本
传统 SaaS 的分析框架是“卖席位 → 人均收入 → 毛利”,AI 产品的成本结构完全不同:训练是一次性的巨额投入,推理成本随调用量线性增长。a16z 在 2020 年就观察到,AI 公司毛利常在 50%–60%,低于同类 SaaS 的 60%–80% 以上,主要原因是算力成本和人工介入[8]。
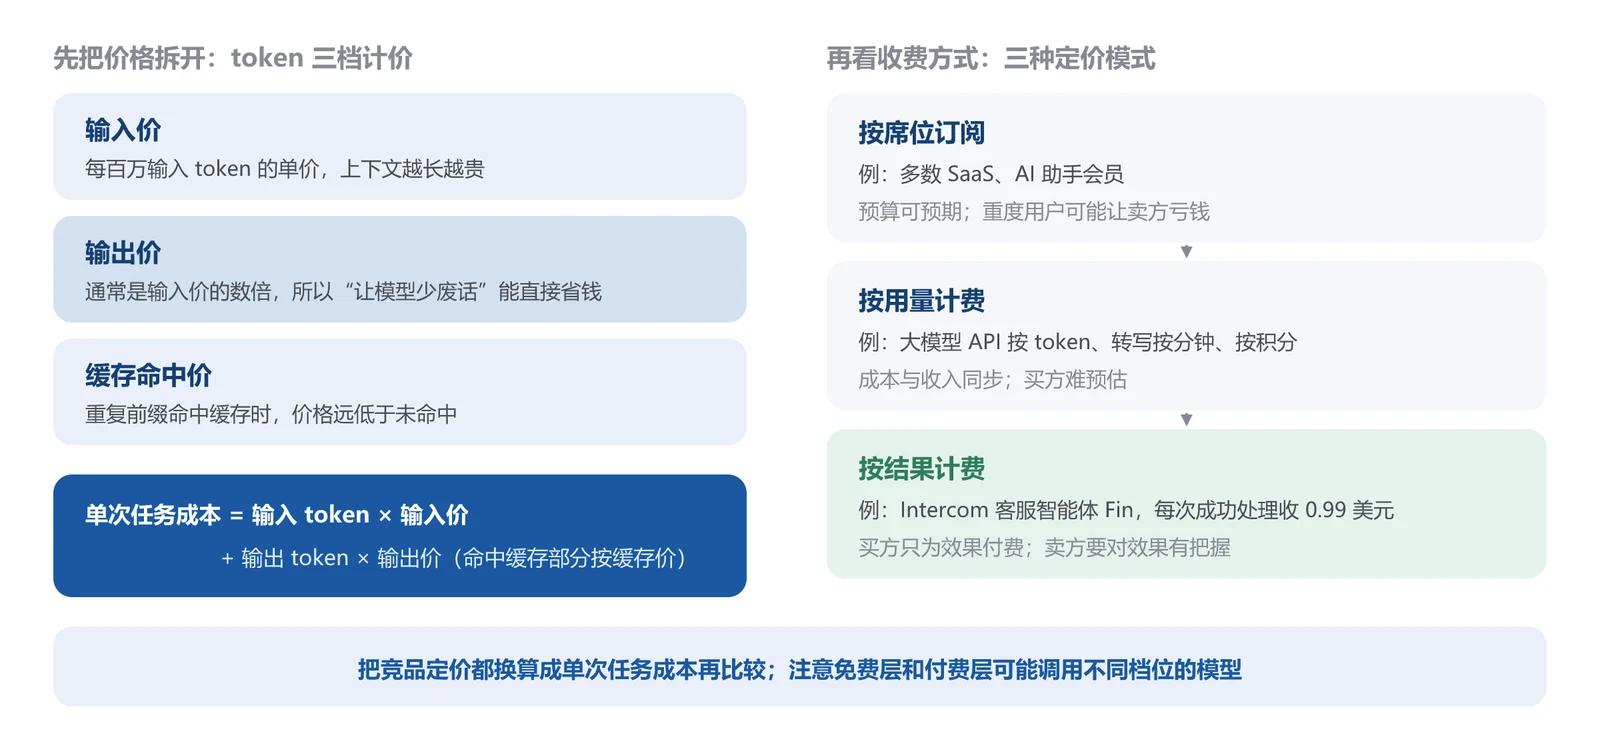
图 10 先把价格拆成 token 三档,再看收费方式;最终都换算成单次任务成本比较
大模型 API 普遍按输入、输出、缓存命中三档计价,输出价通常是输入价的数倍,缓存命中价远低于未命中价,具体以各家官方定价页为准[12][13][14]。分析竞品时要把它的定价换算成“完成一次典型任务要花多少钱”,口径才一致,也才能判断它能不能撑住价格战。
价格格局变化极快。2025 年 1 月,DeepSeek 发布 R1 推理模型,API 价格远低于同期 OpenAI o1;1 月 27 日,DeepSeek 应用登上美国 App Store 免费榜第一,英伟达股价当天下跌约 17%[15]。到 2026 年,市场又出现了两极分化:轻量模型持续降价,部分旗舰模型和编程订阅套餐反而涨价[25]。所以单位经济要定期重算,竞品突然降价时,要追问它是拿到了更便宜的算力,还是换成了更小的模型。
把今天几家主流厂商的官方标价放在一起看(查询于 2026 年 11 月 5 日,统一换算成人民币):
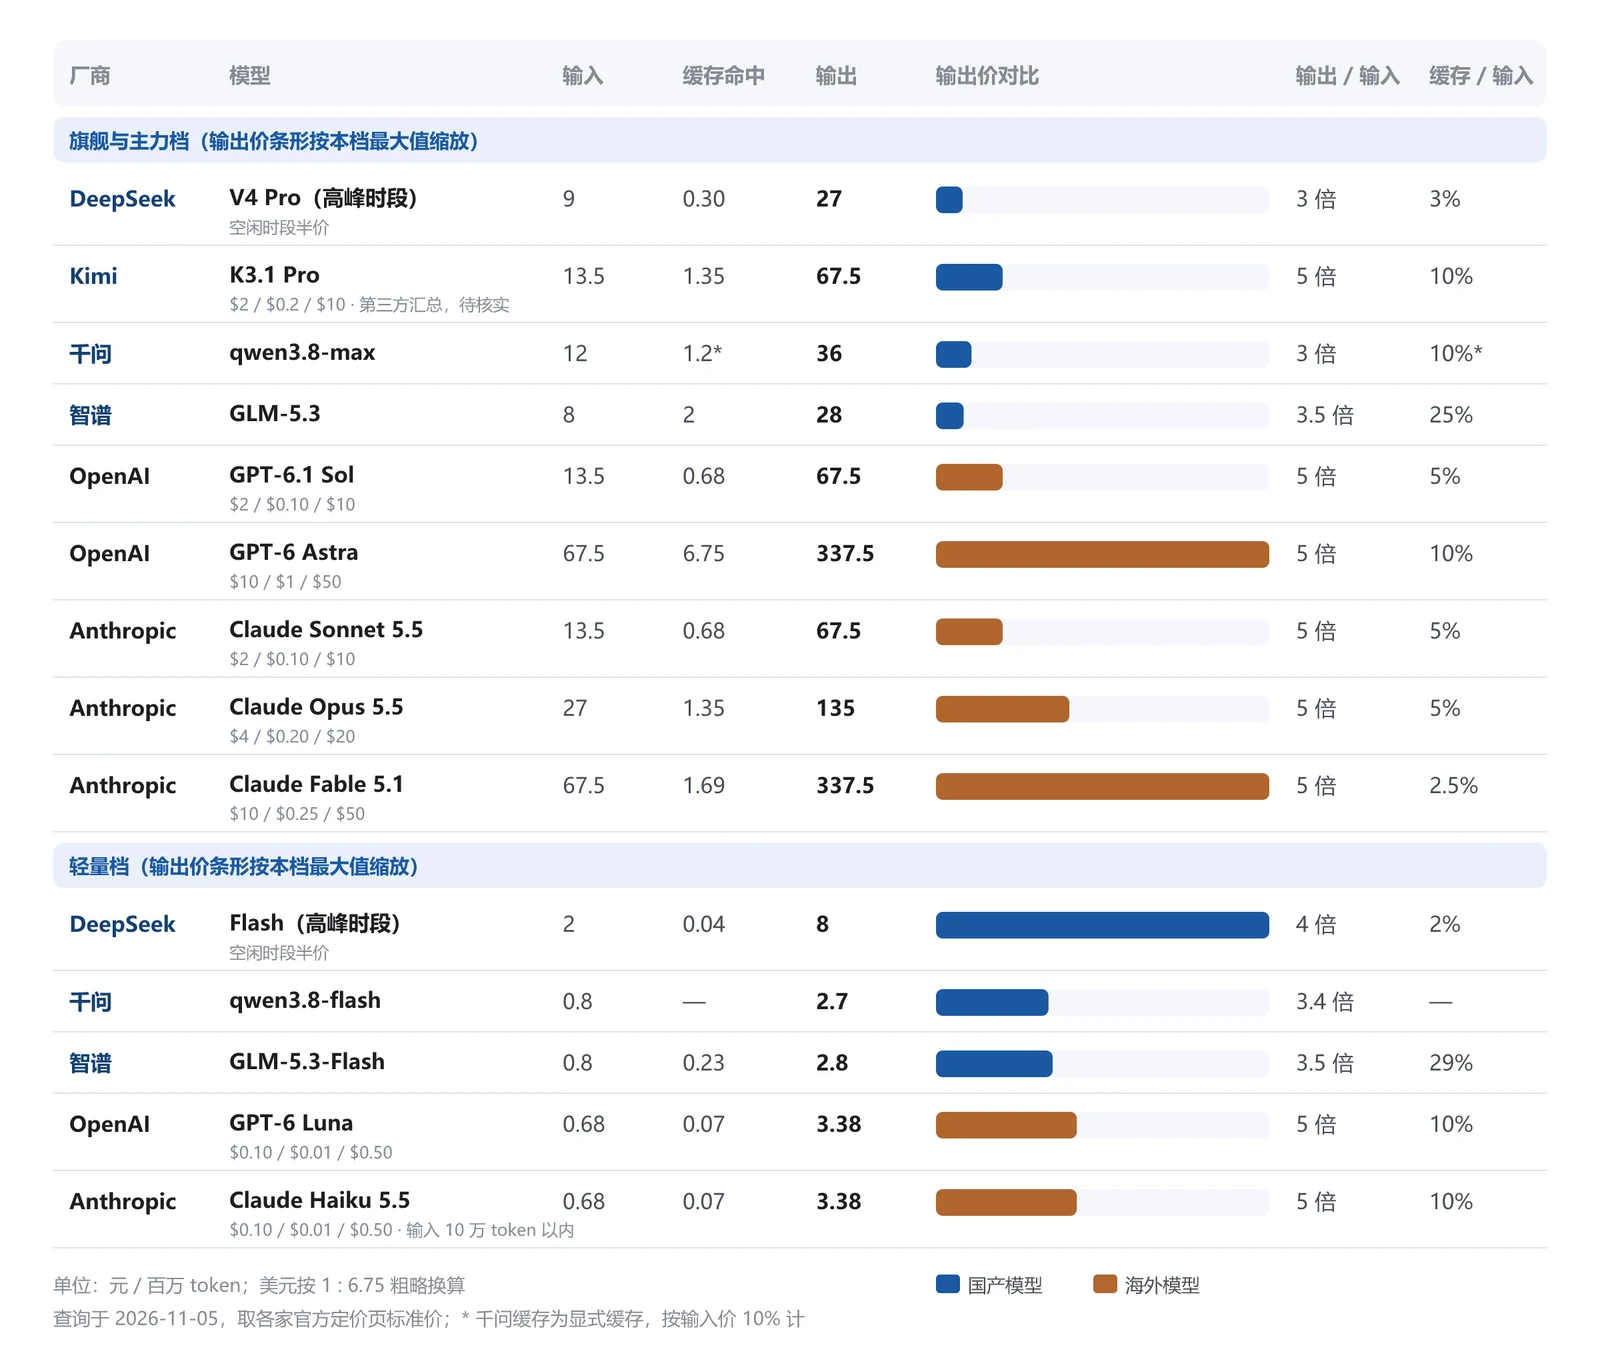
图 11 主流大模型 API 标价对比:DeepSeek、Kimi、千问、智谱与 OpenAI、Anthropic(元 / 百万 token;美元按 1 : 6.75 粗略换算;Kimi 为第三方汇总价,待核实)
这张表能读出四点。第一,旗舰档里,国产模型的标价普遍只有海外模型的几分之一:DeepSeek V4 Pro 高峰时段的输出价是每百万 token 27 元,智谱 GLM-5.3 是 28 元,而 Claude Opus 5.5 约 135 元,GPT-6 Astra 和 Claude Fable 5.1 约 338 元。但档位只是大致对应,能力并不等价,价格一定要和第三节的评测结果放在一起看。
第二,轻量档的价格已经非常接近,甚至出现倒挂:DeepSeek Flash 高峰时段的输出价是 8 元,反而高于 GPT-6 Luna 和 Claude Haiku 5.5 的约 3.4 元。“国产一定更便宜”的印象,在轻量档已经不成立。
第三,缓存折扣的差别比标价还大:DeepSeek 的缓存命中价只有输入价的 2%–3%,OpenAI 和 Anthropic 多在 2.5%–10%,智谱在 25% 左右。对于长上下文、提示词前缀大量重复的智能体类产品,缓存命中率往往决定了真实成本,只比标价会严重误判。
第四,定价方式本身也在竞争:DeepSeek 实行峰谷价,空闲时段半价;千问部分模型按输入长度分档,还会推出限时折扣;输出价普遍是输入价的 3–5 倍。
所以比较竞品的成本时,不要直接比标价,而要按自己的真实调用模式(输入多长、输出多长、缓存命中率多少、在什么时段调用),算出完成一次典型任务的成本。表中价格只代表查询当天的标准价,正式决策前请以各家官方定价页为准[12][14][26][27][28][29]。
收费方式也在演化:从按席位订阅,到按用量计费,再到按结果计费。Intercom 的客服智能体 Fin 按成功处理的结果收费,每次 0.99 美元[11]。越往结果计费走,越像在卖“劳动成果”,而不是卖软件,也越考验卖方对效果的把握。
(二)增长与留存:别被尝鲜流量骗了
AI 产品的尝鲜流量特别大,下载量和访问量很容易被投放和热点推高。红杉资本 2023 年的统计显示,生成式 AI 应用的日活 / 月活比中位数约 14%,而成熟消费应用约 51%;首月留存中位数 42%,对比组为 63%[7]。a16z 建议以第 3 个月作为 AI 产品留存的基线,因为前两个月大量“AI 游客”会流失[10]。
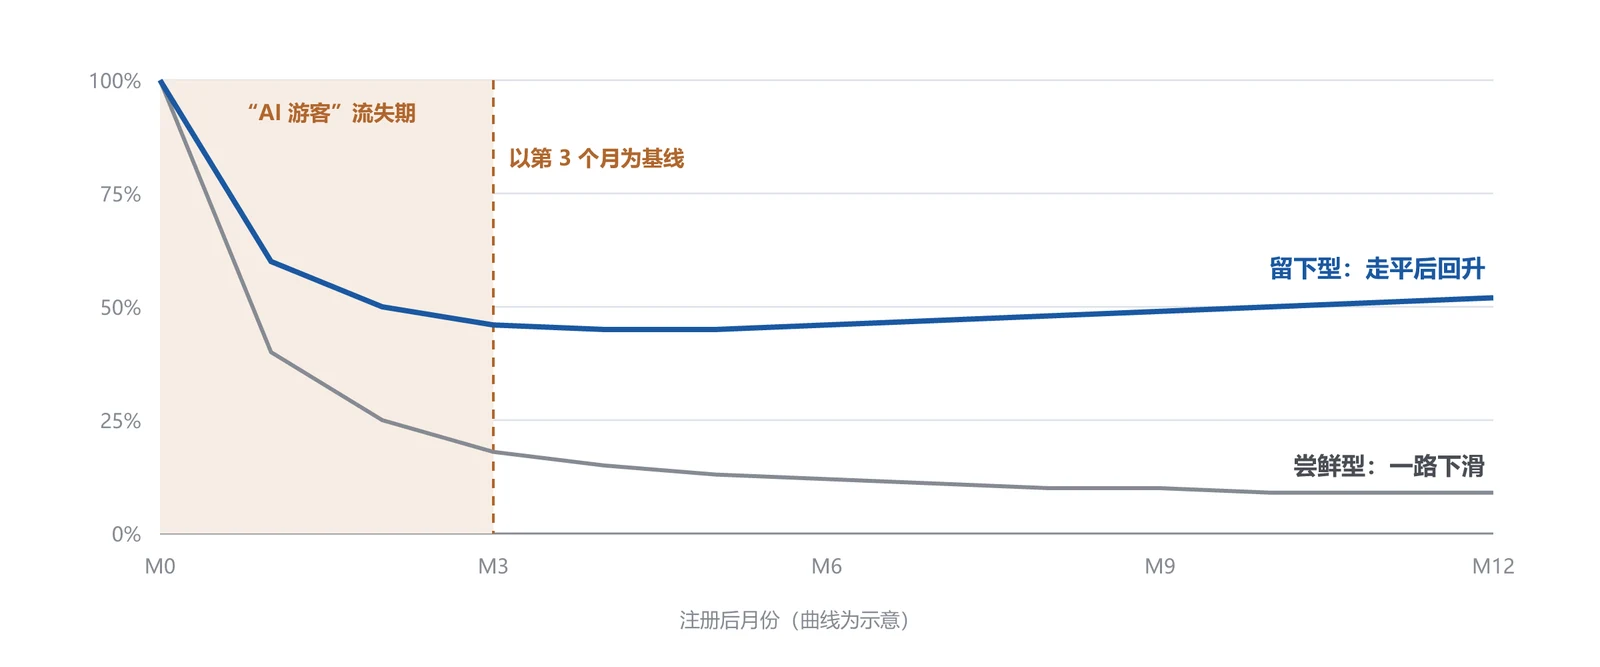
图 12 尝鲜型与留下型 AI 产品的留存曲线示意。对比竞品时,比 M3 之后的曲线形状
国内的例子是 2024 年的大模型应用投放战。据 AppGrowing 等第三方平台估算,Kimi 等应用的月投放达到数千万元甚至更高(月之暗面对部分数据表示不实)[16]。投放能迅速拉高访问量,但留不留得住用户,取决于产品本身。分析这类竞品时,访问量只能说明它花了多少钱,留存和使用频次才说明它做得怎么样。
(三)生态与分发:长在谁的入口里
对 AI 产品来说,生态决定了开发者和企业客户的迁移成本,主要看五件事。一是 API 和 SDK 的兼容性:兼容 OpenAI 接口格式已经是事实标准,兼容得越好,开发者迁移成本越低。二是 MCP(Model Context Protocol):Anthropic 在 2024 年 11 月推出的开放协议,让模型以统一方式连接外部工具和数据[17],看竞品是否支持、生态里有多少可用的服务。三是 Agent 能力:工具调用、长程任务规划。四是开源还是闭源:开源策略直接影响开发者生态和私有化部署的渗透率。五是私有化部署:政府、国企和金融客户的刚需,要看是否提供本地部署版本和配套算力方案。
分发同样关键。a16z 在 2023 年的分析中认为,长期看,行业的收入和利润会流向拥有终端客户的一方[9]。办公套件、即时通讯、浏览器、操作系统里内置的 AI 能力,随时可能把一个细分应用“顺手”做掉。判断竞品(以及我们自己)是否在平台的下一个功能清单上,是这一层必须回答的问题。
(四)合规与安全:准入门槛,不是加分项
在中国,面向公众提供生成式 AI 服务,需要遵守 2023 年 8 月施行的《生成式人工智能服务管理暂行办法》,完成备案或登记[18]。竞品分析要做的动作很具体:查网信办定期发布的生成式 AI 服务备案公告和算法备案系统[19],看对手是否合规上线、有没有新进入者;用敏感问题实测它的内容安全边界,看有没有未成年人模式。出海产品则要关注欧盟《人工智能法》:禁止类条款自 2025 年 2 月起适用,通用模型义务自 2025 年 8 月起适用,大部分规则自 2026 年 8 月起适用,而且对进入欧盟市场的产品都有约束力[20]。
面向企业的 AI 产品,还要看数据政策(用户数据是否用于训练、存在哪里、有哪些安全认证)和智能体安全(提示词注入防护、权限边界、操作留痕)。这些往往比能力更决定能不能签单。
六、综合判断:用“换底座测试”看护城河
把三层看完,最后要回答:竞品的优势能撑多久?最有效的检验方法,就是框架图底部那个问题。
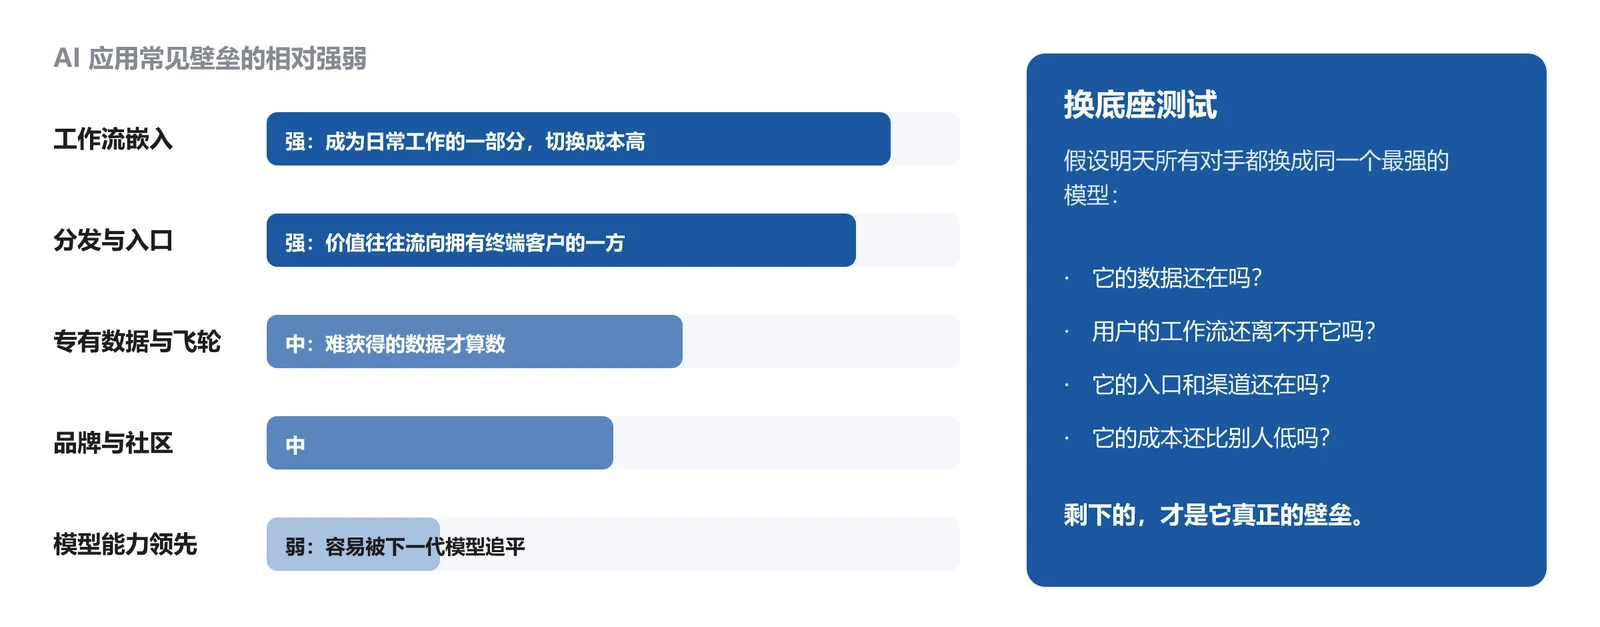
图 13 AI 应用常见壁垒的相对强弱(定性判断),以及换底座测试
模型能力领先是最弱的壁垒,因为下一代模型会把差距抹平,调用 API 的竞争对手也能随时换上更强的模型。真正难复制的是嵌入用户日常工作的工作流、拥有终端客户的入口、难以获得的专有数据,以及更低的成本结构。
AI 编程工具是一个好例子。GitHub Copilot 的优势在分发:它内置于 VS Code、JetBrains 和 GitHub 这些开发者每天使用的地方。Cursor 则基于 VS Code 做了一个以 AI 为主交互的编辑器,靠重做工作流赢得了开发者口碑。两者比的并不是谁的底座模型更强,而是“入口”和“工作流”两种壁垒的较量。
七、持续监测:让分析结论不过期
AI 产品竞品分析最大的敌人是时间。静默升级意味着,即使 API 模型名没变,背后的模型也可能已经换了。所以任何实测报告都必须标注实测日期和调用的模型端点,否则结论不可复现、不可比较。建议按下面的清单持续监测:
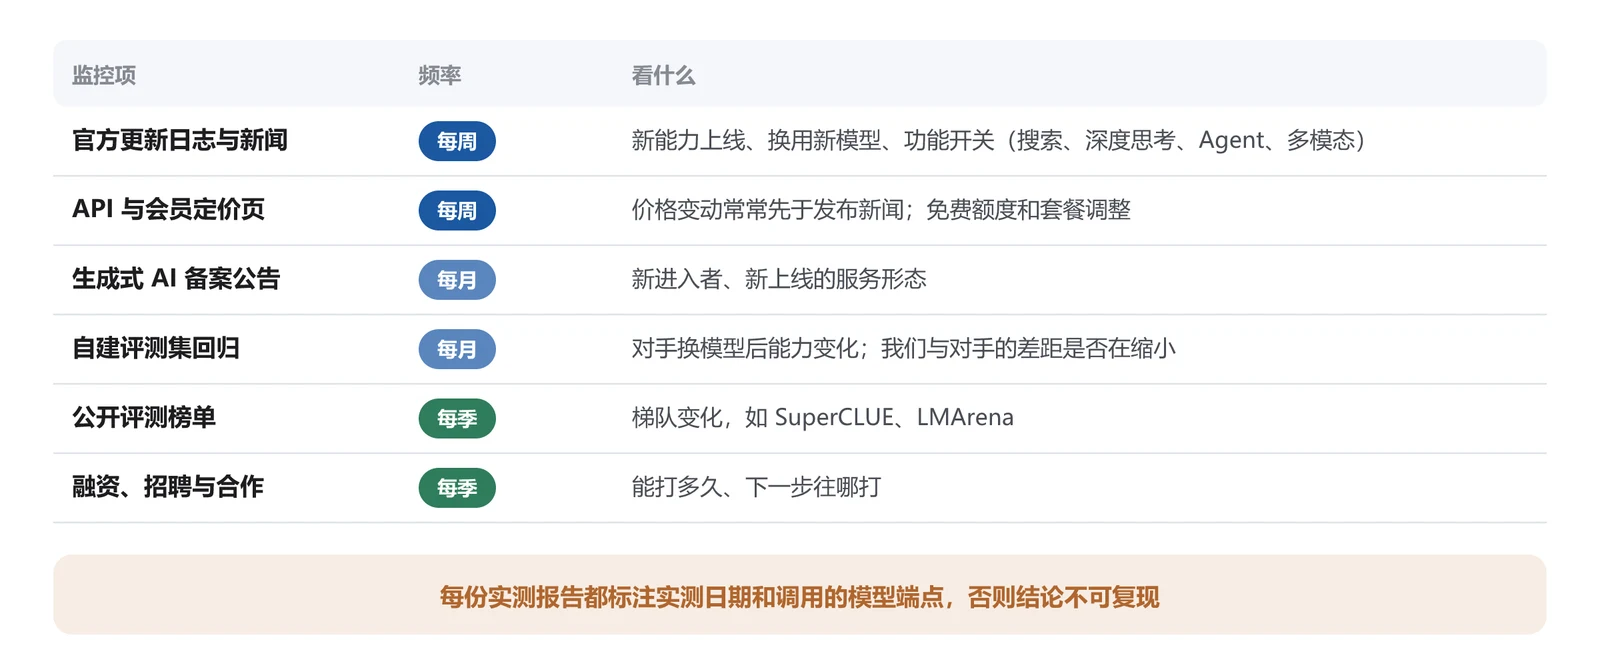
图 14 AI 竞品持续监测清单与频率
其中两条经验值得强调。价格变动常常先于发布新闻出现,盯定价页比盯新闻更早发现对手的动作。自建评测集的月度回归最有价值:它能告诉你,对手换模型之后,我们之间的差距是在缩小还是在扩大。
八、两个案例
(一)国内外通用大模型:能力差距与定位差异
第一个案例用真实的公开数据,看国内外代表性通用大模型的差距在哪里,顺便验证第三节那条原则:榜单只能定梯队,而且换一个榜单,结论的力度就不一样。
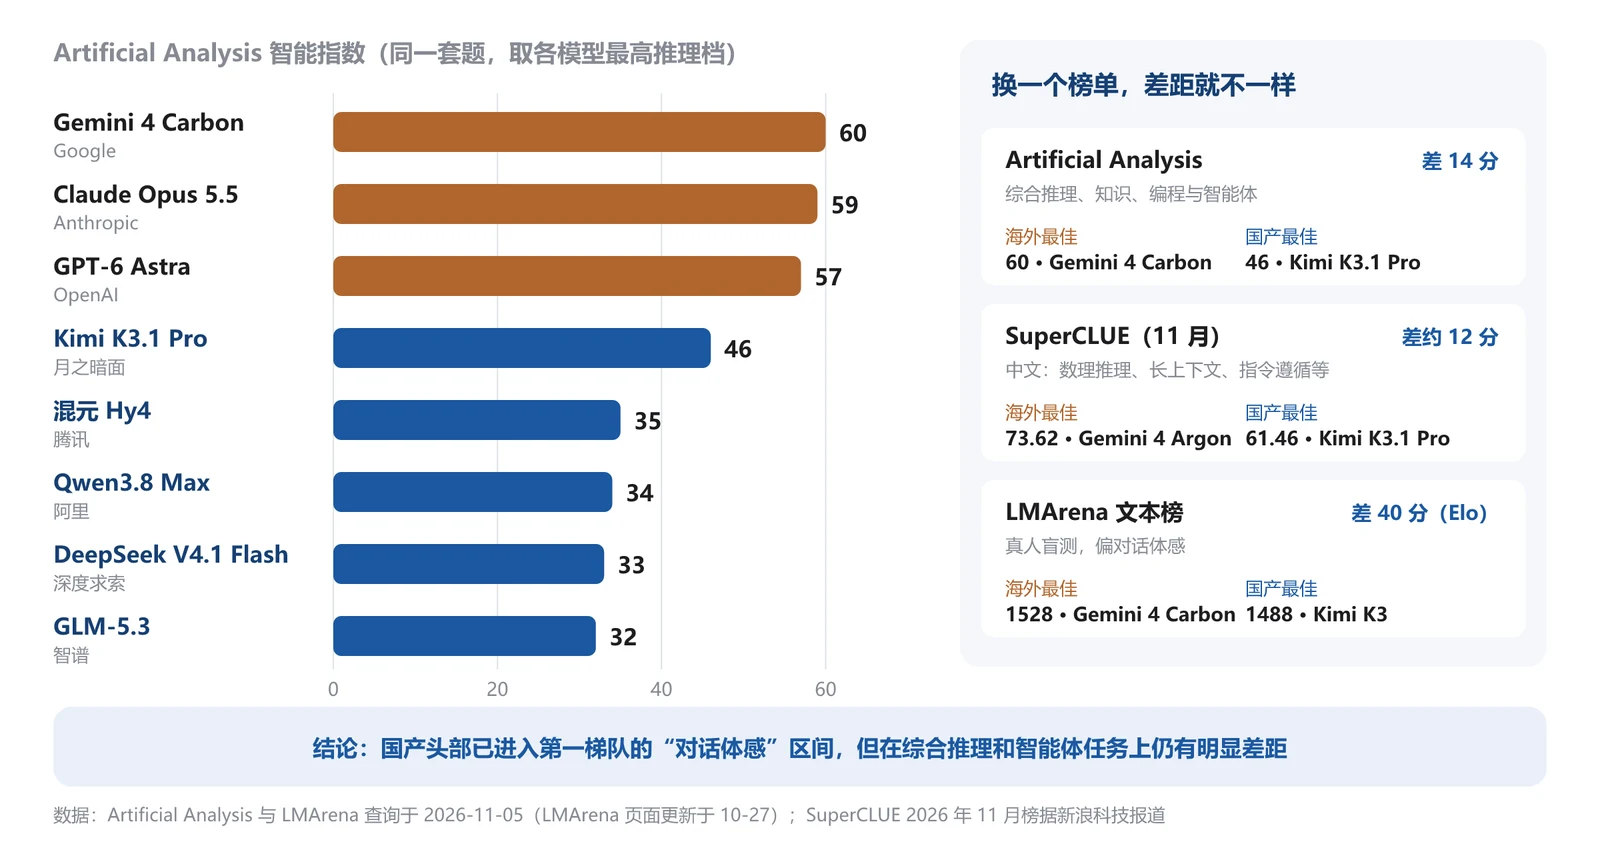
图 15 国内外代表性通用大模型的能力对比(Artificial Analysis 智能指数与三个榜单的差距,查询于 2026 年 11 月 5 日)
先看能力。 在 Artificial Analysis 的智能指数上(同一套题,覆盖推理、知识、编程和智能体任务),第一梯队是 Google 的 Gemini 4 Carbon(60)、Anthropic 的 Claude Opus 5.5(59)和 OpenAI 的 GPT-6 Astra(57);国产模型中最高的是 Kimi K3.1 Pro(46),腾讯混元 Hy4、千问 Qwen3.8 Max、DeepSeek V4.1 Flash 和智谱 GLM-5.3 集中在 32–35 分[31]。但换一个榜单,差距的大小就变了:在偏综合能力的中文榜 SuperCLUE 2026 年 11 月榜上,海外最佳 Gemini 4 Argon 73.62 分,国内最佳 Kimi K3.1 Pro 61.46 分,差约 12 分[32];在真人盲测、偏对话体感的 LMArena 文本榜上,Gemini 4 Carbon 1528 分,Kimi K3 1488 分,千问 Qwen3.8-Max、智谱 GLM-5.3 也都在 1480 分上下,差距只有几十分[33]。合起来的结论是:国产头部模型在日常对话体验上已经接近第一梯队,但在复杂推理和智能体任务上仍有明显差距。 如果你的产品主打日常问答和内容生成,国产模型的性价比优势很大;如果主打复杂的智能体任务,差距就需要认真评估。
再看定位。 能力差距之外,各家的打法也完全不同。
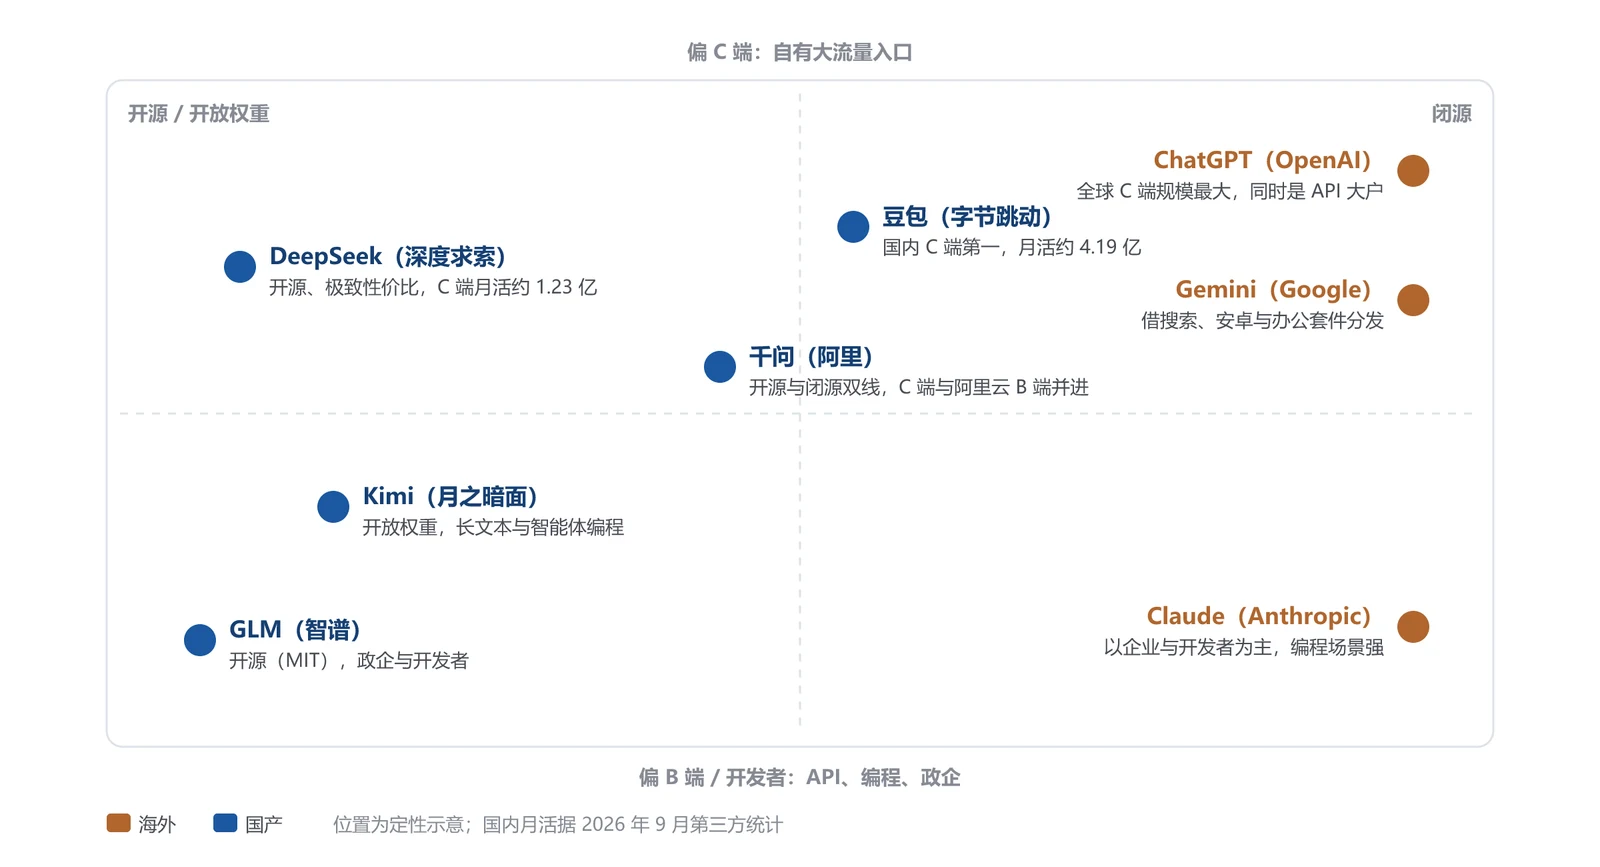
图 16 国内外通用大模型的定位地图:开源还是闭源,偏 C 端还是偏 B 端(定性示意)
海外三强都是闭源,但重心不同:ChatGPT 是全球 C 端规模最大的 AI 应用,同时也是 API 大户;Gemini 借助搜索、安卓和办公套件分发;Claude 则以企业和开发者为主,编程场景是它的强项。国内则呈现“C 端靠流量、B 端靠开源”的格局:豆包依托抖音的内容和流量,2026 年 9 月月活约 4.19 亿,居国内第一;千问开源和闭源双线并进,月活约 1.58 亿,同时带动阿里云的 B 端业务;DeepSeek 以开源和极致性价比切入,月活约 1.23 亿[23];Kimi、智谱则以开放权重为主,重心在开发者、长文本、智能体编程和政企市场。
这个案例对做竞品分析有两点启示。第一,比能力一定要看清榜单测的是什么,单拿一个榜单下结论,很容易被带偏。第二,能力相近的模型,定位可以完全不同:同样分数在 30 多分的几家国产模型,有的靠 C 端流量,有的靠开源生态,有的靠云业务,它们的真正对手和增长逻辑并不一样。
(二)AI 编程助手:用三层框架走一遍
假设你在做一款 AI 编程助手,要分析两个主要竞品。按三层框架推进(示例为示意)。
技术底座层:查官方文档,竞品 A 基于自研模型,竞品 B 接入多家模型、允许用户切换;在公开榜单上确认两者的能力区间和价格带;准备 30 道覆盖代码补全、bug 修复、跨文件重构、文档生成的固定题目,双盲打分、每题多次采样;用一个带复杂依赖的真实项目做压力测试,观察上下文丢失情况。
产品体验层:A 是 IDE 插件加后台 Agent 双形态,复杂任务完成质量高,但响应偏慢;B 主打编辑器内嵌,速度快、上手门槛低,但复杂任务需要频繁人工接管。容错设计上,A 对所有自动修改都提供 diff 预览和一键回滚,B 的确认环节薄弱。
商业生态层:A 按席位订阅,定价偏高,走企业客户路线;B 个人版低价走量,靠规模摊薄成本,近期拿到新一轮融资,正在大力投入开发者社区。
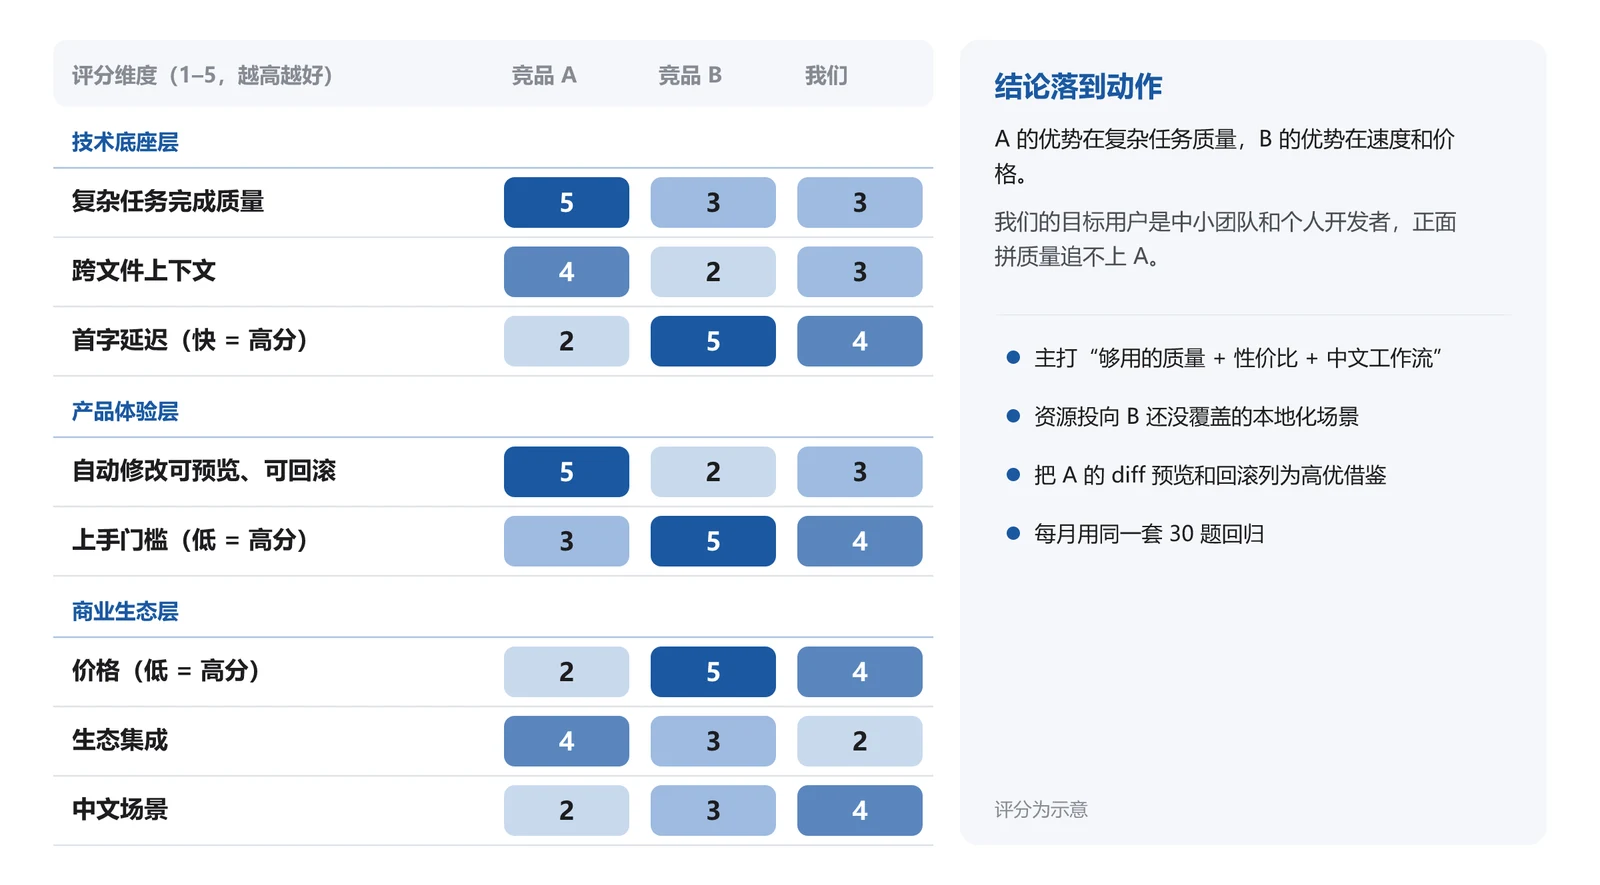
图 17 AI 编程助手三层评分卡与结论(评分为示意)
真实的 AI 编程赛道还提供了一个关于数据口径的教训。据新浪财经报道,IDC 发布过两组口径完全不同的市场份额数据,排名前列的厂商在两组数据里截然不同[24],这说明赛道格局未定、统计窗口很短,引用任何份额数字都要注明口径。另一个值得拆解的打法是字节的 Trae:它长期以免费策略换取用户规模,后来国际版才转为按 token 计费[24],这是“成本层 + 生态层”组合打法的典型样本。分析这个赛道,除了看模型跑分,更要看 IDE 插件、独立 IDE、命令行三种形态是否齐全,免费额度策略,与自家云和模型的绑定关系,以及商业化节奏。
九、AI 竞品分析特有的五个坑
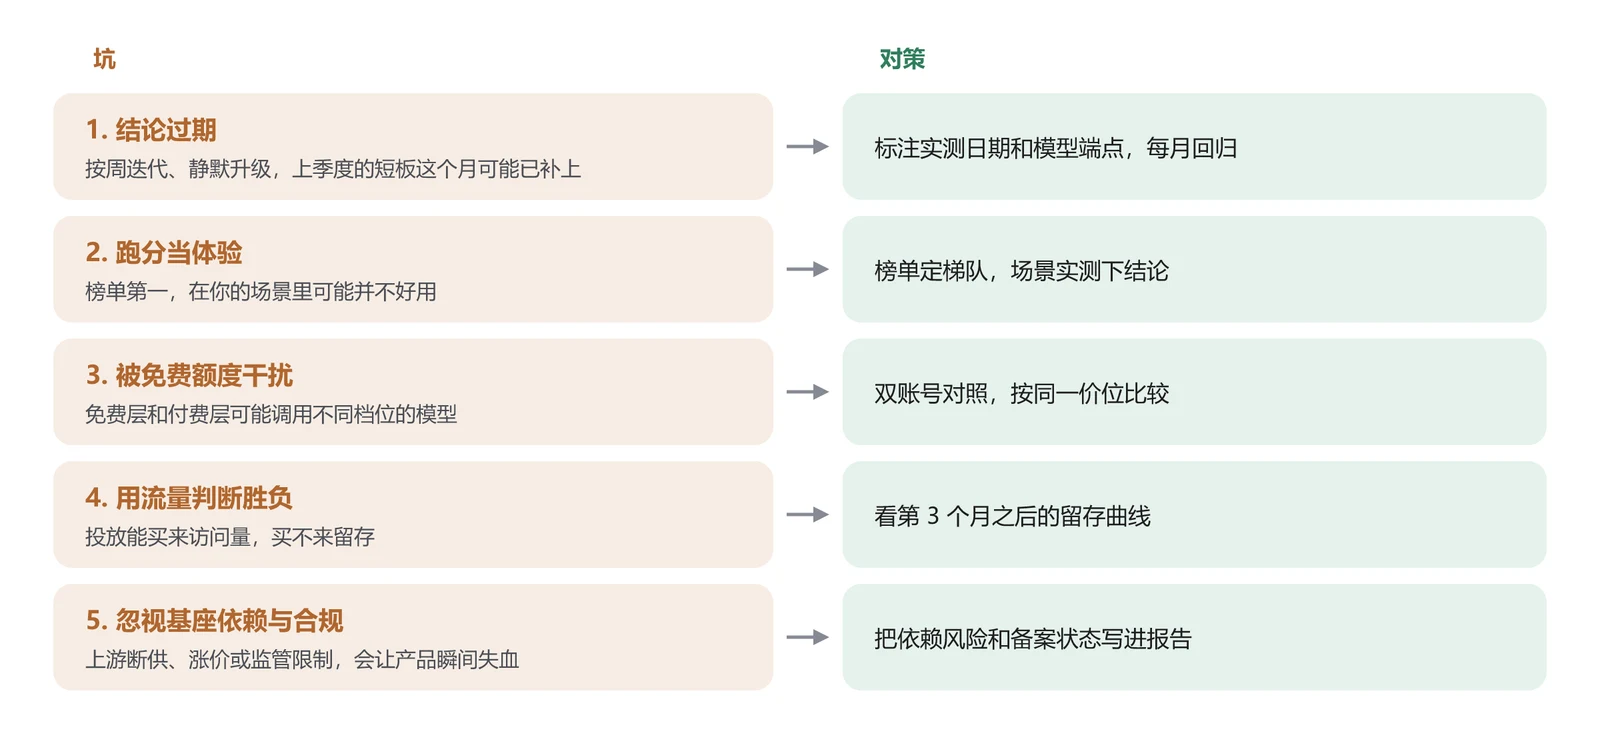
图 18 AI 竞品分析特有的五个坑与对策
第三个坑最隐蔽:免费层和付费层调用的可能是不同档位的模型。实测时如果只用付费账号,就会拿竞品最强配置的表现,去对标它的入门价格。
结语
AI 产品的竞品分析,变的是拆解对象:从功能列表深入到模型、数据、工作流和成本结构;不变的是分析逻辑:带着自己的问题来,用实测代替传闻,让结论落在行动上。
最后附上一张可以直接带走的维度清单,做竞品分析时逐行打勾即可。
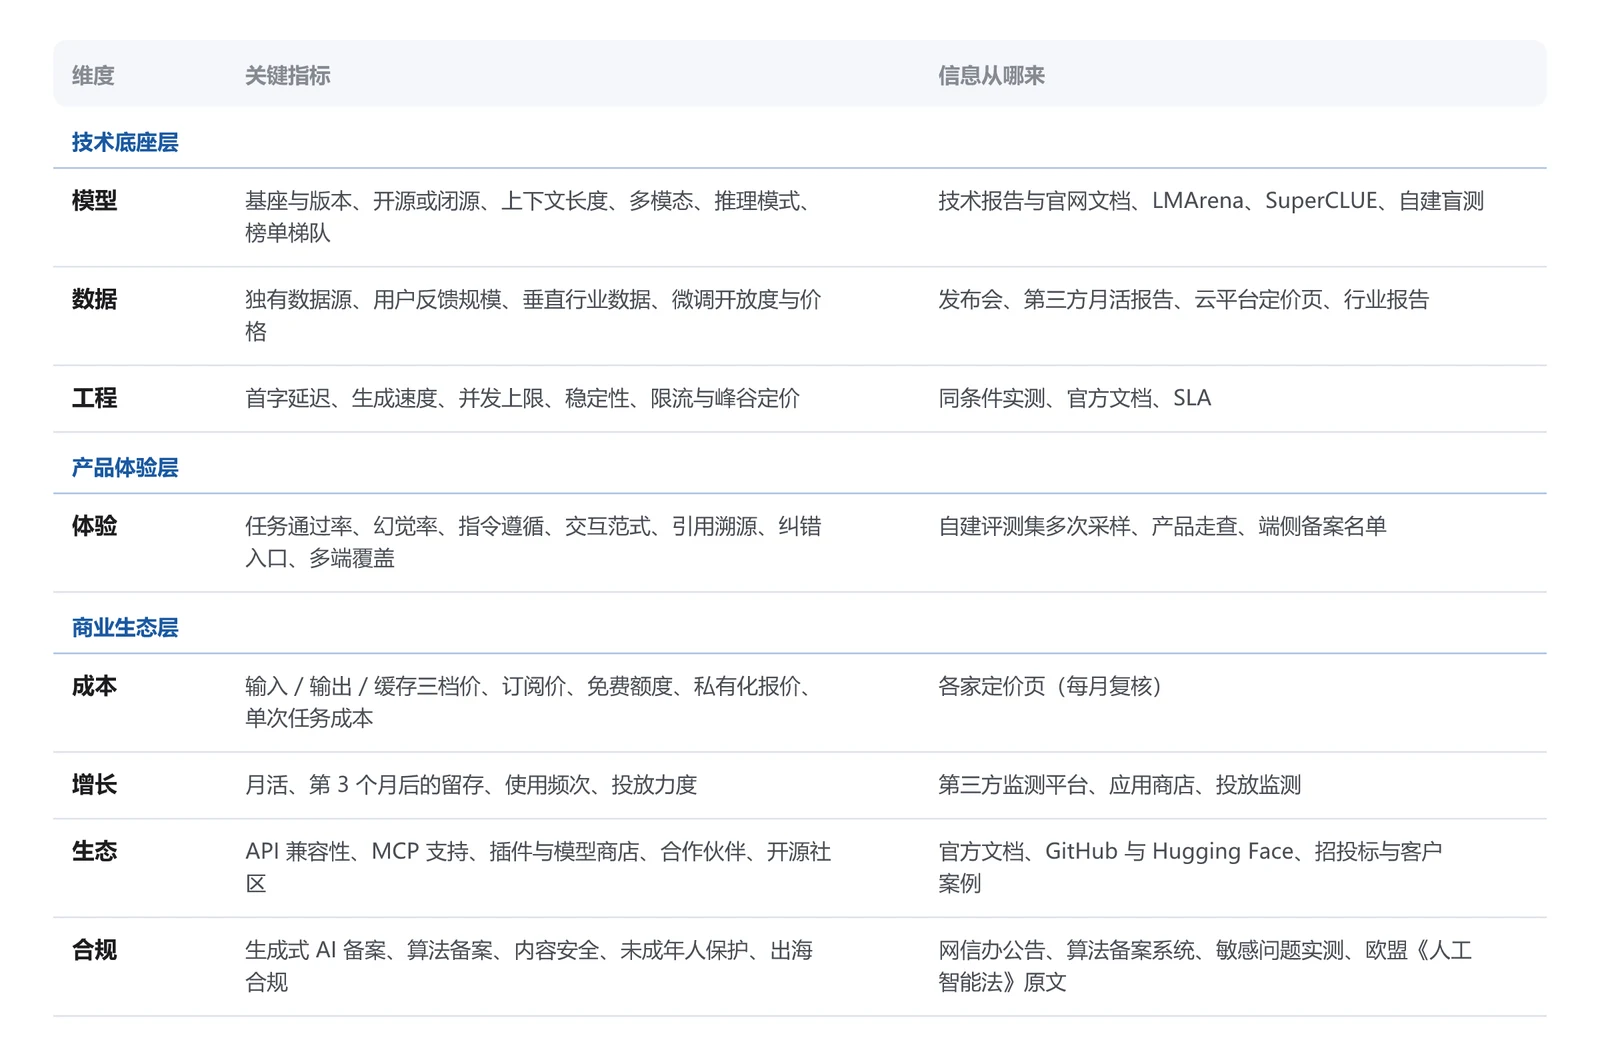
图 19 AI 产品竞品分析维度清单:关键指标与信息来源
方法和对象都讲完了,下一篇解决最后一个问题:如何让 AI 成为你的竞品分析助手,同时避开它一本正经编造事实的坑。
参考资料
- 中国经济网,信通院魏凯访谈,2025-07-02,http://www.ce.cn/xwzx/gnsz/gdxw/202507/t20250702_2347159.shtml
- LMArena,https://lmarena.ai
- Singh 等,《The Leaderboard Illusion》,arXiv,2025,https://arxiv.org/abs/2504.20879 ;LMArena 的回应,https://news.lmarena.ai/our-response
- SuperCLUE General Leaderboard,https://www.superclueai.com/generalpage
- Hugging Face,《LLM Evaluation Guidebook》,https://openevals-evaluation-guidebook.hf.space/the-llm-evaluation-guidebook.pdf
- Artificial Analysis,https://artificialanalysis.ai
- Sequoia Capital,《Generative AI’s Act Two》,2023,https://sequoiacap.com/article/generative-ai-act-two
- a16z,《The New Business of AI (and How It’s Different From Traditional Software)》,2020,https://a16z.com/the-new-business-of-ai-and-how-its-different-from-traditional-software/
- a16z,《Who Owns the Generative AI Platform?》,2023,https://a16z.com/2023/01/19/who-owns-the-generative-ai-platform/
- a16z,《AI retention benchmarks》,https://a16z.com/ai-retention-benchmarks/
- Intercom 定价页,https://www.intercom.com/pricing
- DeepSeek API 定价,https://api-docs.deepseek.com/zh-cn/quick_start/pricing/
- 火山引擎模型服务价格,https://www.volcengine.com/docs/82379/1544106
- OpenAI API 定价,https://developers.openai.com/api/docs/pricing
- The National,DeepSeek R1 与英伟达股价,2025-01-27,https://www.thenationalnews.com/future/technology/2025/01/27/deepseek-ai-r1-stock/
- 新浪财经,Kimi 投放相关报道,2024-11-22,https://finance.sina.com.cn/roll/2024-11-22/doc-incwzmiw7048377.shtml
- Anthropic,《Introducing the Model Context Protocol》,2024-11,https://www.anthropic.com/news/model-context-protocol ;协议文档 https://modelcontextprotocol.io
- 国家网信办等,《生成式人工智能服务管理暂行办法》,2023,https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- 网信办生成式 AI 服务备案公告,https://www.cac.gov.cn/2026-09/14/c_1791136833136332.htm ;算法备案系统,https://beian.cac.gov.cn/
- European Commission,AI Act,https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
- 人人都是产品经理,AI 竞品分析复盘,http://m.toutiao.com/group/7641800638515413519/
- 掘金,TTFT 与成本控制,https://juejin.cn/post/7669778081063108662
- 新浪财经,2026 年 9 月 AI App 月活榜,http://finance.sina.cn/stock/jdts/2026-10-21/detail-inivzcqf6101775.d.shtml
- 新浪财经,《AI 编程 IDE 四分天下》,https://finance.sina.com.cn/stock/relnews/hk/2026-09-13/doc-inirsuvu7687983.shtml ;界面新闻,Trae 用户规模,https://www.jiemian.com/article/14788309.html
- 21 世纪经济报道,国产大模型涨价潮,http://m.toutiao.com/group/7676010502560858674/ ;新浪财经,大模型原厂涨价,https://finance.sina.com.cn/wm/2026-09-05/doc-iniqtspw3780984.shtml
- Anthropic,Pricing,https://platform.claude.com/docs/en/about-claude/pricing
- 阿里云百炼,模型价格,https://help.aliyun.com/zh/model-studio/model-pricing
- 智谱开放平台,价格说明,https://docs.bigmodel.cn/cn/guide/start/pricing
- Kimi 开放平台,模型推理价格说明,https://platform.kimi.com/docs/pricing/chat ;第三方汇总 BenchLM,https://benchlm.ai/moonshot/api-pricing (2026-11-04 更新)
- 汇率参考:2026 年 9 月 28 日美元兑人民币中间价 6.7399,https://news.10jqka.com.cn/20260928/c680300044.shtml
- Artificial Analysis,Intelligence Index 排行榜,https://artificialanalysis.ai/leaderboards/models (查询于 2026-11-05)
- 新浪科技(转载快科技),《最强中文大模型出炉:Gemini 领跑总榜、Kimi 国内第一》,2026-11-05,https://finance.sina.com.cn/tech/roll/2026-11-05/doc-inixrqen6329065.shtml
- LMArena,Text Arena 排行榜,https://arena.ai/leaderboard/text (页面更新于 2026-10-27)
说明:文中标注“示意”的图表用于说明方法,数据为虚构或定性示例,不代表任何产品的真实表现。价格、份额、月活等数据时效性强,正式决策前请以官方页面为准。所有配图的可编辑 SVG 源文件在 images/svg 目录下。