如何用 AI 做竞品分析:人机分工、工作流与提示词
用 AI 做竞品分析,核心是分工:人负责定义问题、核验事实、下判断,AI 负责收集、整理、写初稿和“唱反调”。本文给出工具组合、提示词写法和八步工作流,提示词可以直接复制使用。
目录 · 10 节
竞品分析三部曲 · 第三篇。第一篇讲方法论,第二篇讲 AI 产品怎么分析,本篇讲怎么让 AI 当你的竞品分析助手:它能做什么、不能做什么,每一步具体怎么用。
2024 年 12 月 Google 推出 Gemini Deep Research,2025 年 2 月 OpenAI 和 Perplexity 相继推出各自的深度研究功能[1][2][3]。从此,输入一个问题,几分钟后就能拿到一份带引用、结构完整的竞品报告。很多人以为竞品分析被“一键解决”了。
但这类报告直接拿去用,问题很多。第一,看起来对不等于真的对:OpenAI 在发布时就说明,深度研究可能编造事实、做出错误推断,也可能难以区分权威信息和传言[2];2026 年一项针对商业大模型和深度研究智能体的研究发现,它们给出的引用链接中约 3%–13% 从未存在过,5%–18% 无法打开,深度研究智能体的引用幻觉率还更高[4]。第二,人人都能拿到同样的报告:对手用同样的工具、问同样的问题,得到的结论也差不多。第三,AI 不知道你的资源约束和业务背景,无法为结论负责。
先说结论: 用 AI 做竞品分析,核心是分工。人负责定义问题、核验事实、下判断;AI 负责收集、整理、结构化、写初稿和“唱反调”。每一条事实都必须能回溯到原文,内部数据一律不喂给公开模型。本文按“分工 → 工具 → 提示词 → 八步工作流 → 风险与核验”展开。正文里有 10 条可以直接复制使用的提示词:⓪ 帮你写提示词,①到⑨ 对应工作流的每一步。
一、有了 AI,竞品分析变了什么、没变什么
竞品分析的工作可以分成两类:一类是收集、整理、归纳、结构化、写初稿,机械、重复、耗时;另一类是定目标、辨事实、做判断、出洞察,依赖业务认知和行业经验。AI 把前一类工作大幅压缩了,后一类基本没变,其中“核验事实”反而要花更多时间。
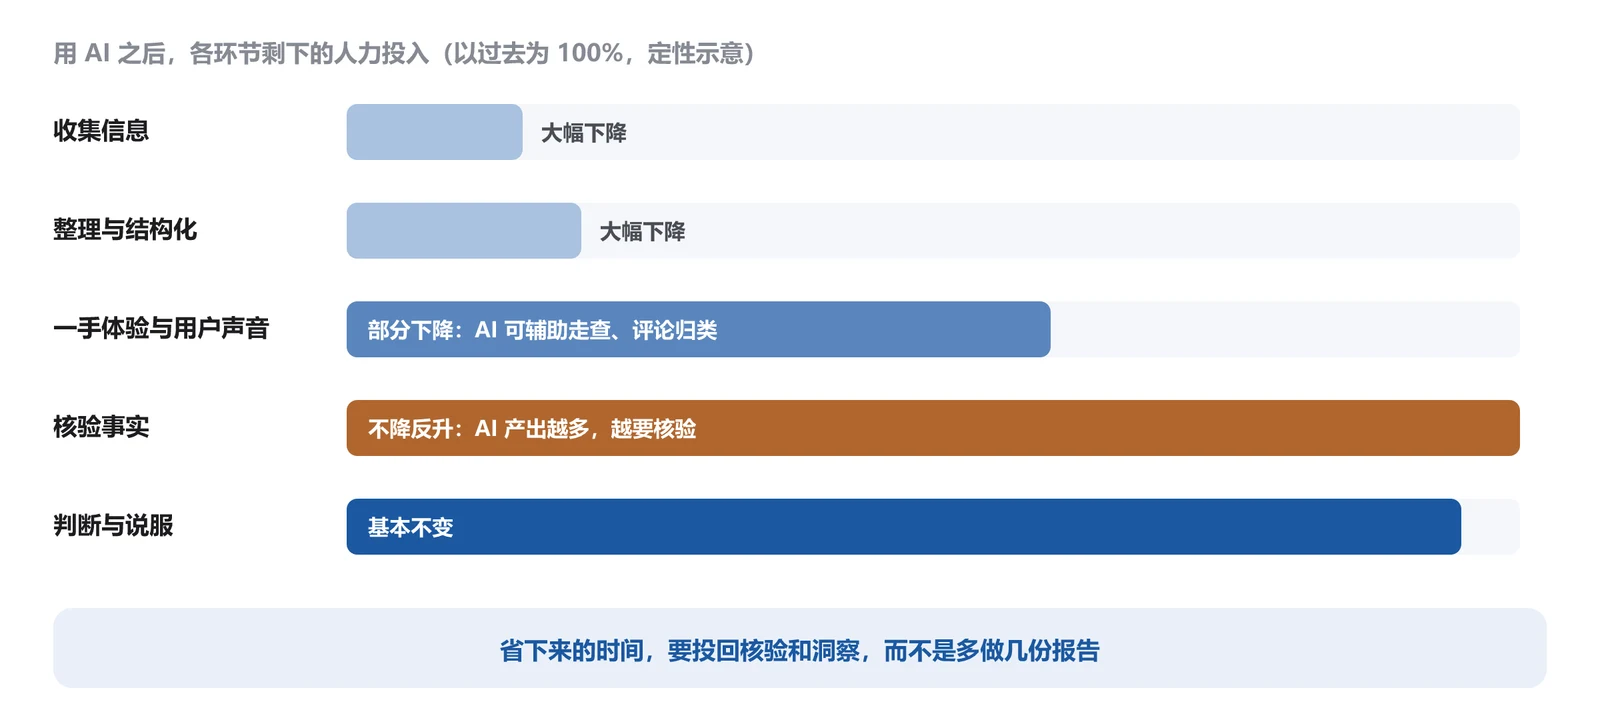
图 1 用 AI 之后,各环节剩下的人力投入(定性示意)
于是,竞品分析拉开差距的地方变了:过去比谁收集得多,现在比谁问得准、谁有一手数据、谁判断得对。 公开信息谁的 AI 都能找到;你的用户访谈、销售反馈、自建评测集,对手的 AI 找不到。
二、人机分工:两头由人把关,中间交给 AI
把竞品分析拆成七个环节,就能看清每一段该谁上手。
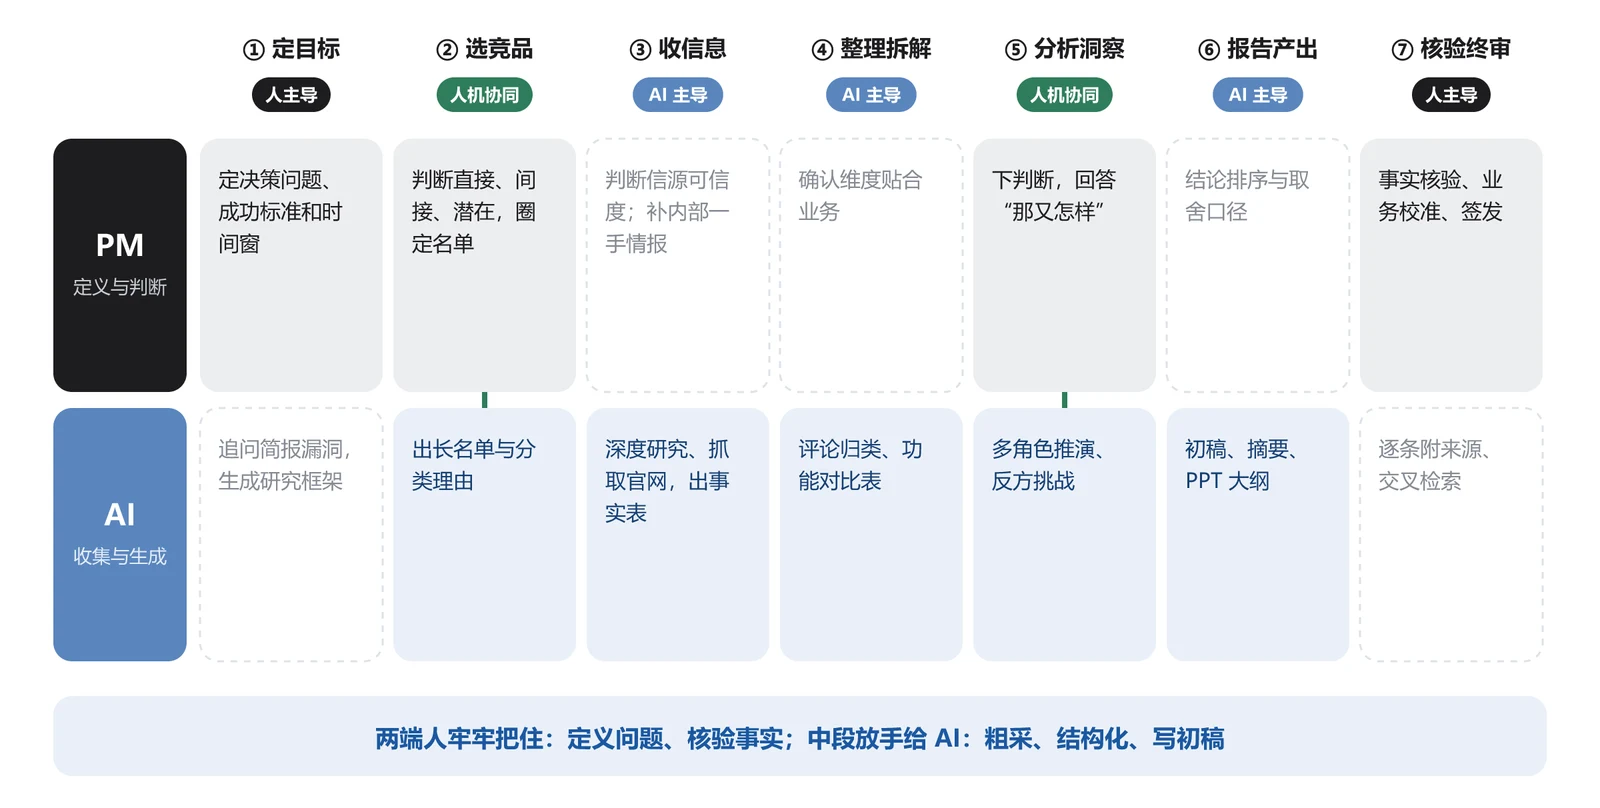
图 2 人机分工泳道图。深色是该环节的主导方,虚线框是辅助方
新手最容易踩的坑是环节错位:让 AI 替你定目标,它只会顺着你模糊的说法套模板;让 AI 替你拍板事实,它会产生幻觉。合理的分工是:粗采、结构化、写初稿这三段交给 AI,它最擅长;定义问题和核验事实这两头,必须由人来做。中间的“选竞品”和“分析洞察”是人机协同:AI 负责扩大视野,人负责取舍。
三、选工具:按产出物分工组合
没有哪一个工具能把竞品分析从头做到尾。 比较稳妥的做法是按产出物分工:事实交给搜索型和深度研究工具,分析文字交给长文档与写作能力强的模型,数据图交给能执行代码的模型,演示交给演示工具。多个智能体可以并行采集,但执笔只能有一个。
(一)工具全貌:八类工具各管一段
做竞品分析能用上的 AI 工具,大致可以分成八类,各管一段。
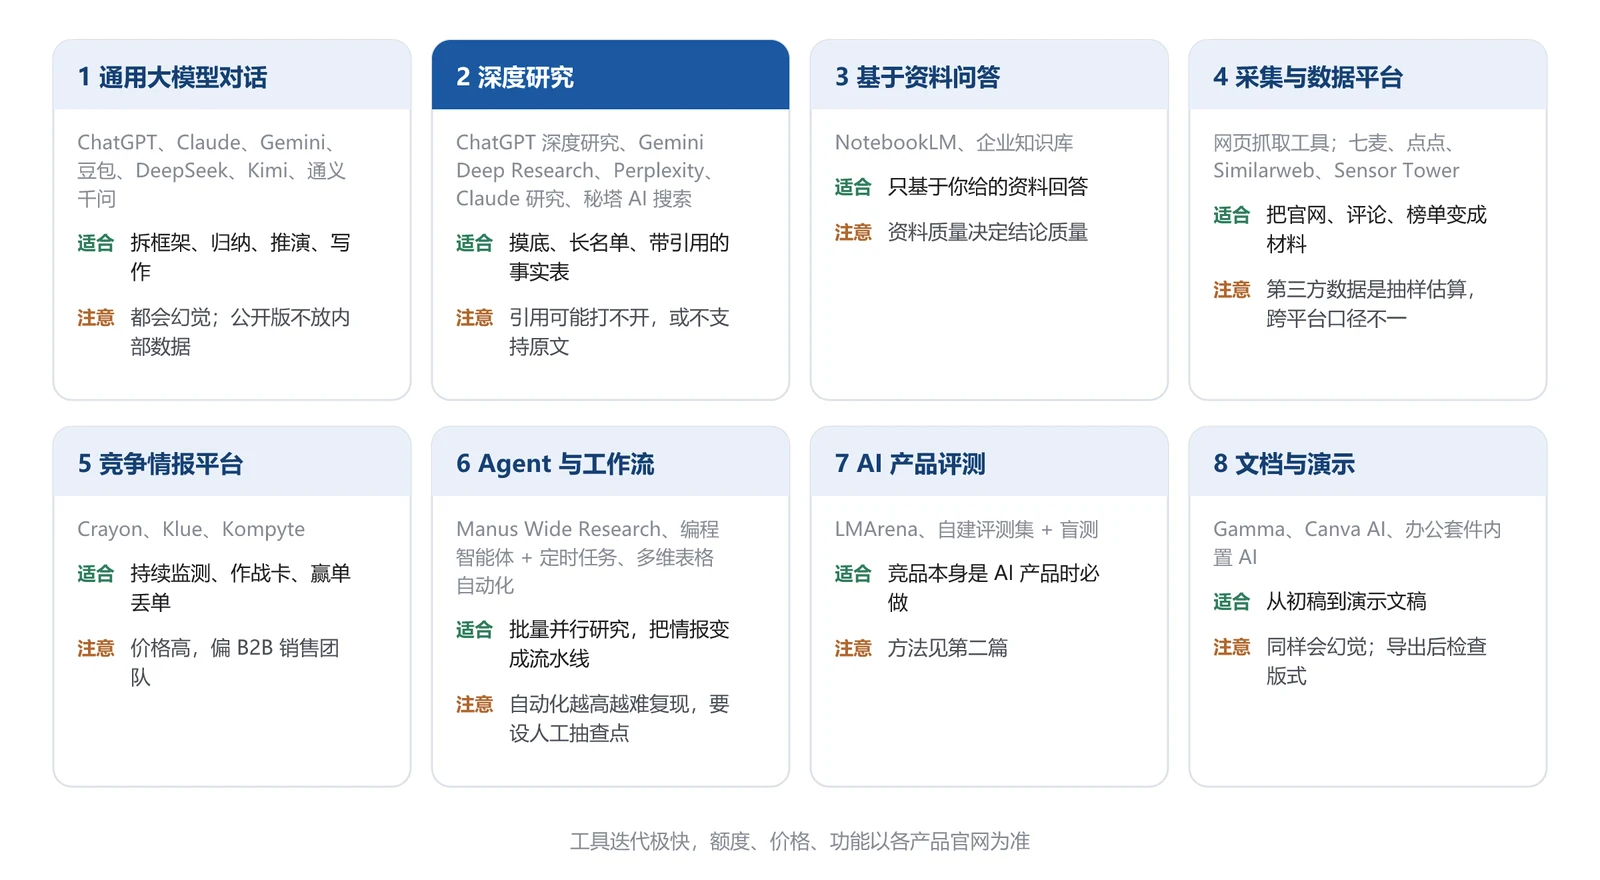
图 3 AI 竞品分析工具版图(工具迭代极快,以各产品官网为准)
(二)典型工具:各自擅长什么
具体到产品,下面是做竞品调研时最常用的几款,以及它们的长处和短板。
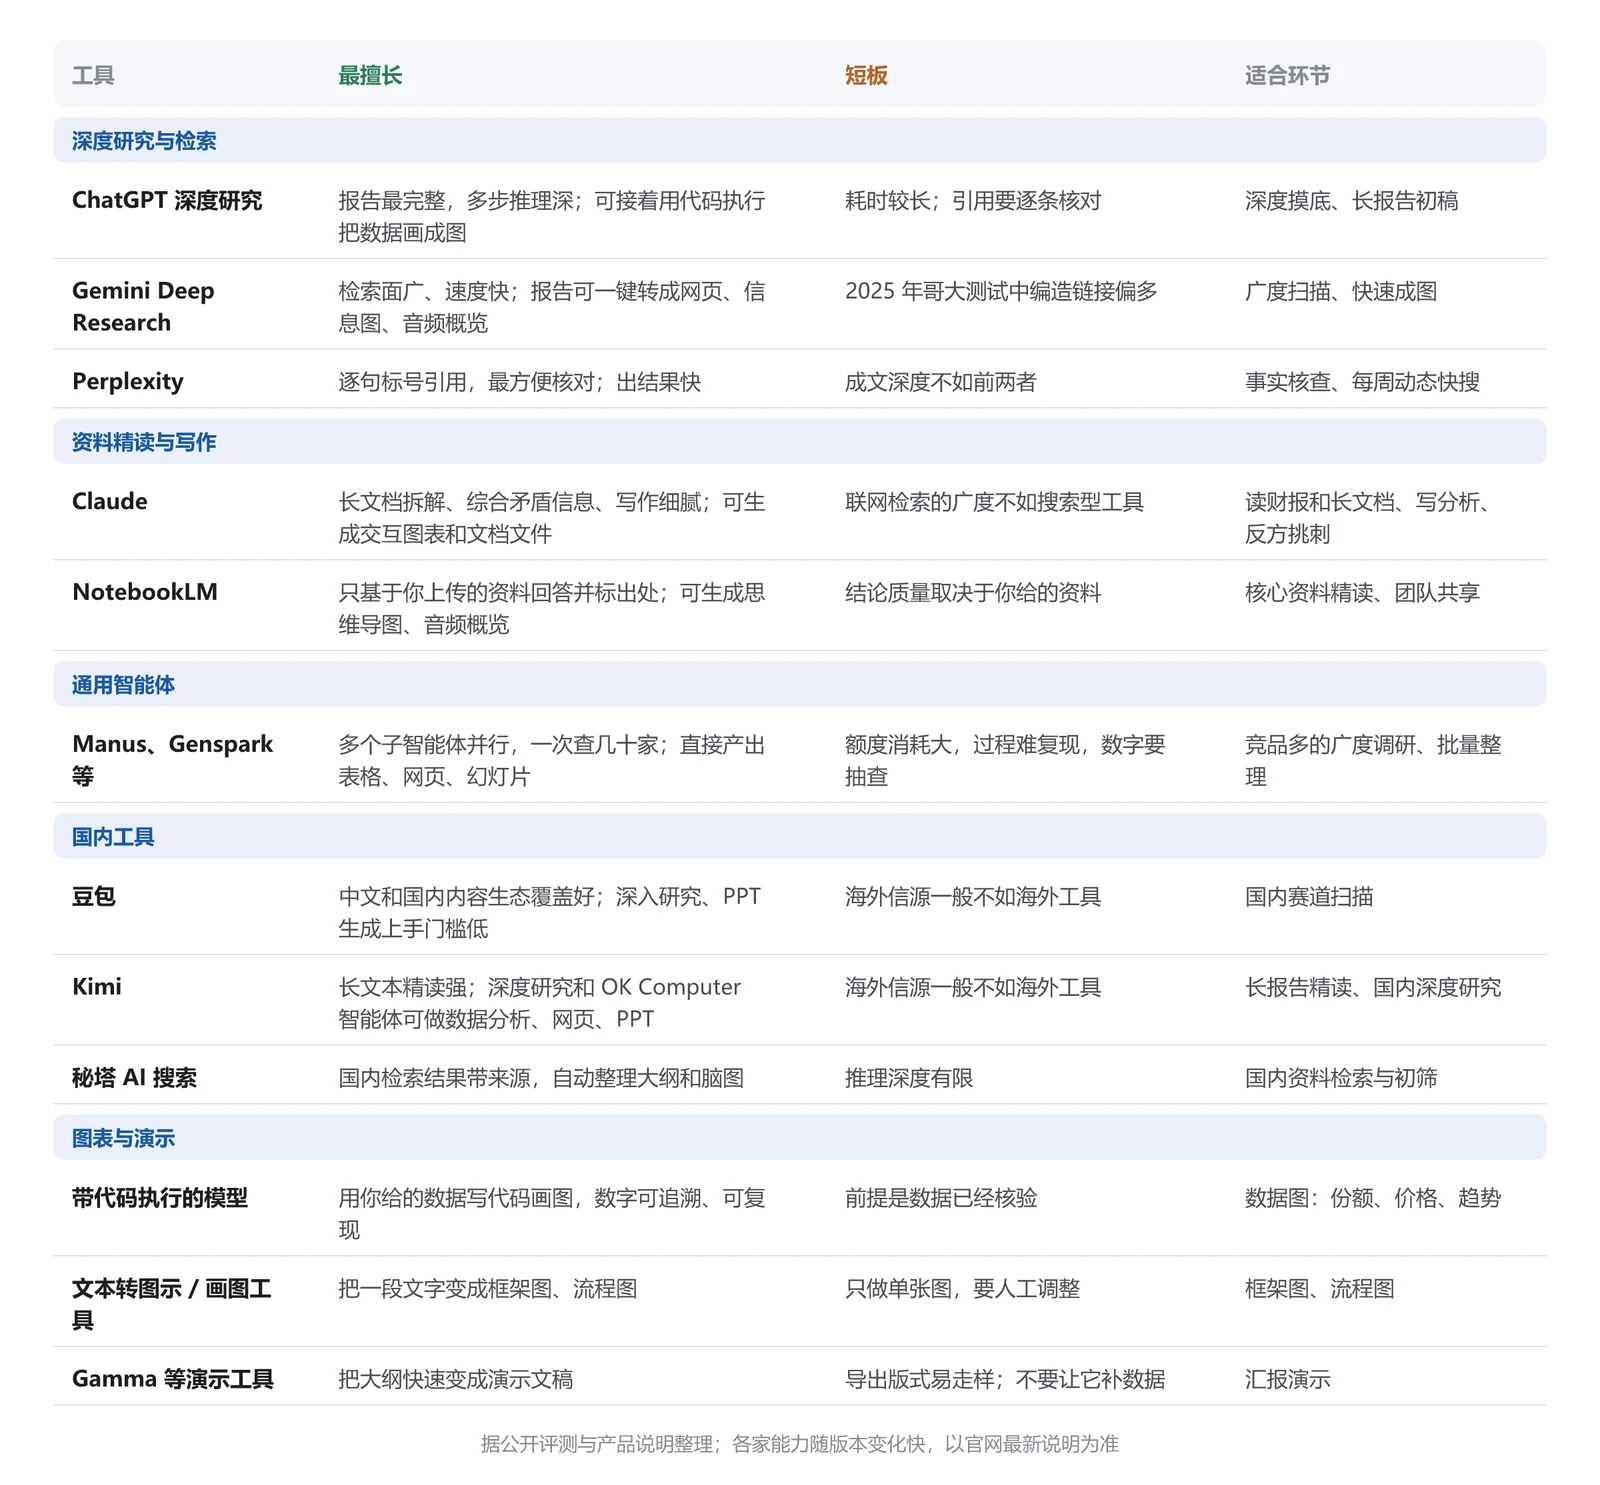
图 4 典型 AI 工具的擅长、短板与适合环节(据公开评测与产品说明整理,能力随版本变化)
三款深度研究工具各有侧重。 ChatGPT 的深度研究报告最完整、推理链最长,适合出深度初稿,代价是耗时更长[3];Gemini Deep Research 检索面广、速度快,报告可以在 Canvas 里一键转成网页、信息图和音频概览[11];Perplexity 逐句标注引用,最方便核对,适合做事实核查和每周的动态快搜。但要注意,引用格式整齐,不等于引用正确。2025 年哥伦比亚大学数字新闻研究中心测试了 8 款 AI 搜索工具,在约 1600 次查询中,它们整体答错的比例超过 60%;表现最好的 Perplexity 错误率约 37%,最差的 Grok 3 高达 94%,Gemini 和 Grok 3 给出的编造链接甚至多于正确链接[7]。所以无论用哪一款,关键引用都要抽查。
精读和写作交给另一类工具。 Claude 擅长拆解长文档、综合互相矛盾的信息,写作也更细腻,适合读财报、写分析和做反方挑刺;NotebookLM 只基于你上传的资料回答并标出出处,适合把筛好的核心资料交给它精读,或者分享给团队。
国内赛道和海外赛道,信源差别很大。 研究国内赛道时,政策文件、本土公司、应用商店评论、公众号和社交平台内容,国内工具(豆包、Kimi、秘塔 AI 搜索等)覆盖更全;研究海外赛道,海外工具更好。两边都涉及时,各用一个,再交叉比对。
图表要分两类处理。 数据图(份额、价格、趋势)交给能执行代码的模型,把核验过的数据给它,让它写代码画图,脚本留存,数字可追溯、可复现;框架图和流程图交给文本转图示或画图工具,再由人调整结构。Kimi 的 OK Computer 等智能体模式可以直接产出网页和 PPT[12],很方便,但其中出现的每个数字同样要回到事实表核对。不要用文生图模型画带数字的图表,它会画出“看起来很对”的错误数字。
(三)单智能体,还是多智能体
用 AI 做调研,常有人问该用一个智能体还是多个。业界有两种看起来相反的观点,放在一起看,答案就清楚了。
Anthropic 公开过它的深度研究系统:一个主智能体负责拆解问题,再派出多个子智能体并行检索,最后汇总。在其内部的研究评测中,这种多智能体系统比单智能体的表现高出 90.2%,尤其擅长需要同时朝多个独立方向展开的“广度型”问题;代价是消耗的 token 约为普通对话的 15 倍[8]。另一边,AI 编程公司 Cognition 发表过《Don’t Build Multi-Agents》,指出并行的子智能体看不到彼此的上下文,会做出互相冲突的隐含决定,拼起来的结果前后矛盾[9];它在 2026 年的跟进文章里仍然认为,让多个智能体并行“写”同一份产出的做法不可靠[10]。
两者并不矛盾:多智能体适合并行“读”,不适合并行“写”。 落到竞品分析上,就是下面三种组织方式。
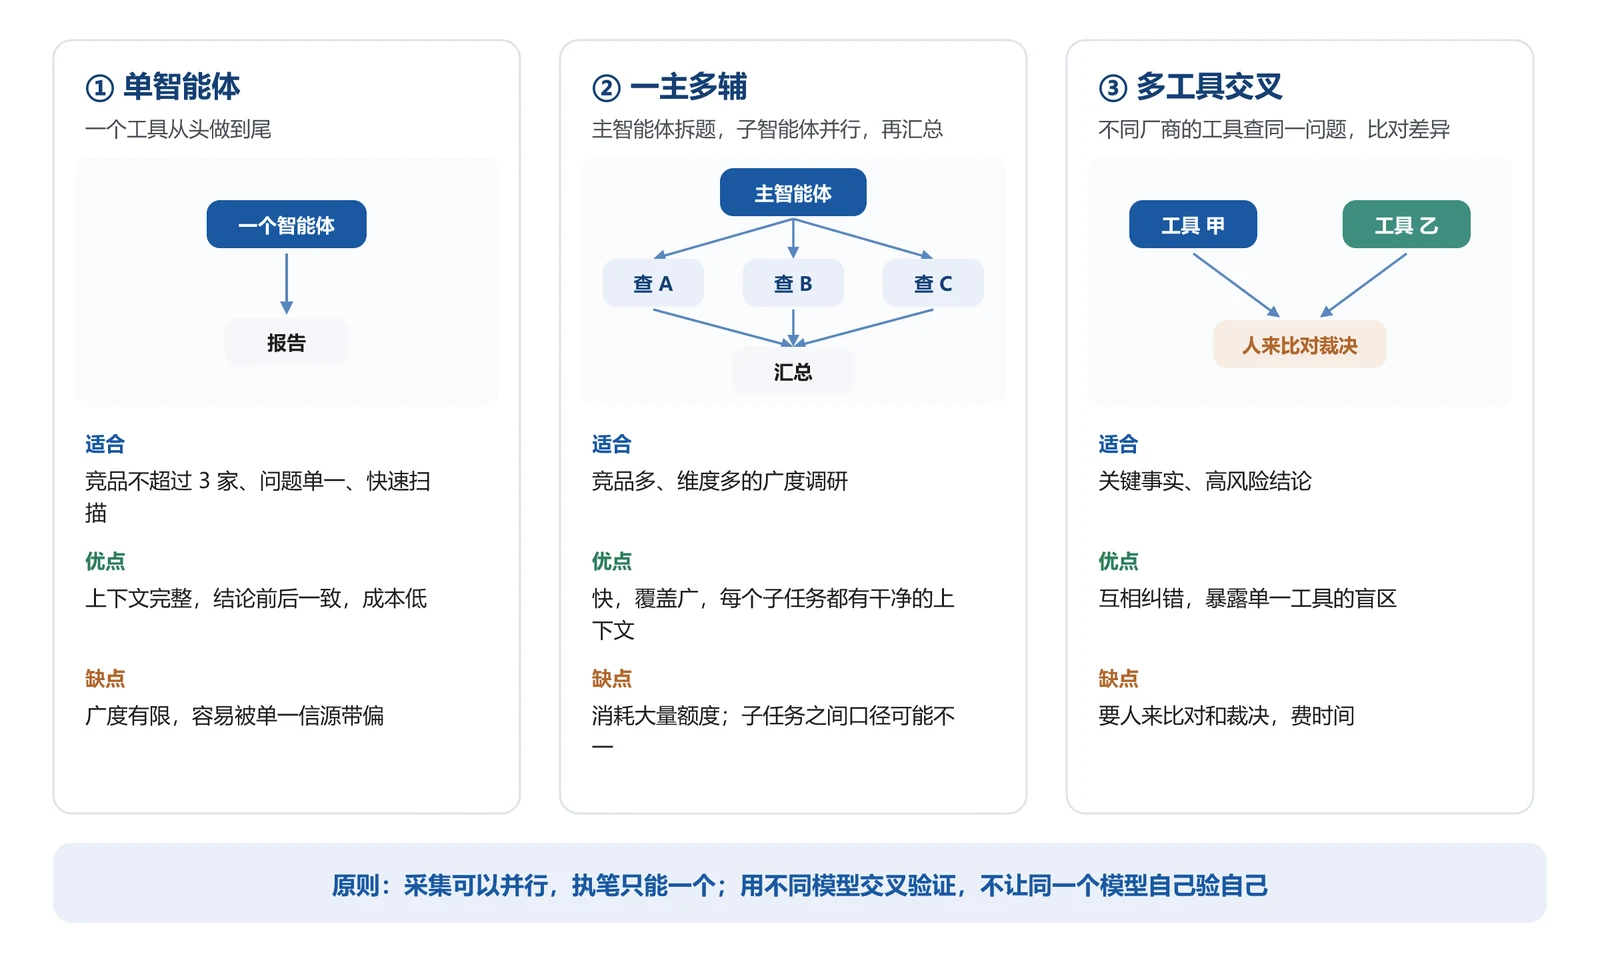
图 5 三种组织方式:单智能体、一主多辅、多工具交叉
怎么选:竞品不超过 3 家、问题单一的快速扫描,一个工具从头做到尾就够了;竞品多、维度多的广度调研,用一主多辅的方式并行采集,每个子任务查一家或一个维度,但汇总和成文交给一个智能体(或者你自己);会写进结论页的关键事实和高风险判断,用两个不同厂商的工具查同一个问题,比对差异,由人来裁决。最常见的错误,是让几个智能体分头写报告的不同章节再拼起来,结果口径不一、前后矛盾。
(四)文字和图表:分别交给谁
一份竞品报告由四类产出组成:事实、分析文字、图表、演示。它们最好按顺序交给不同的工具完成,而且都从同一份核验过的事实表出发。
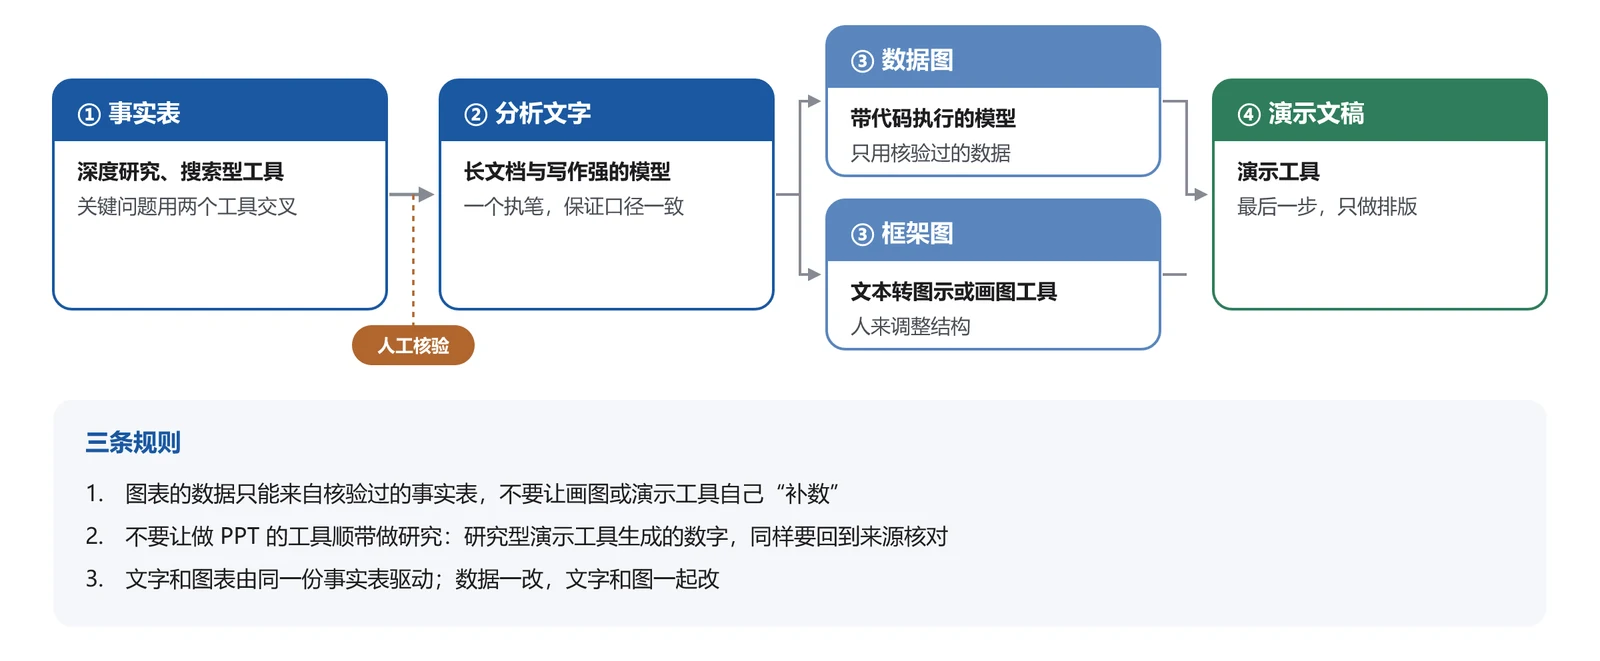
图 6 从事实表到演示文稿的分工流水线
顺序很重要:先有核验过的事实表,再写文字,再画图,最后才做演示。很多人倒过来,先让演示工具“一键生成”整套 PPT,再去补证据,结果是演示里出现了大量无法溯源的数字。
(五)按场景选组合
把上面的原则落到三种最常见的场景上:
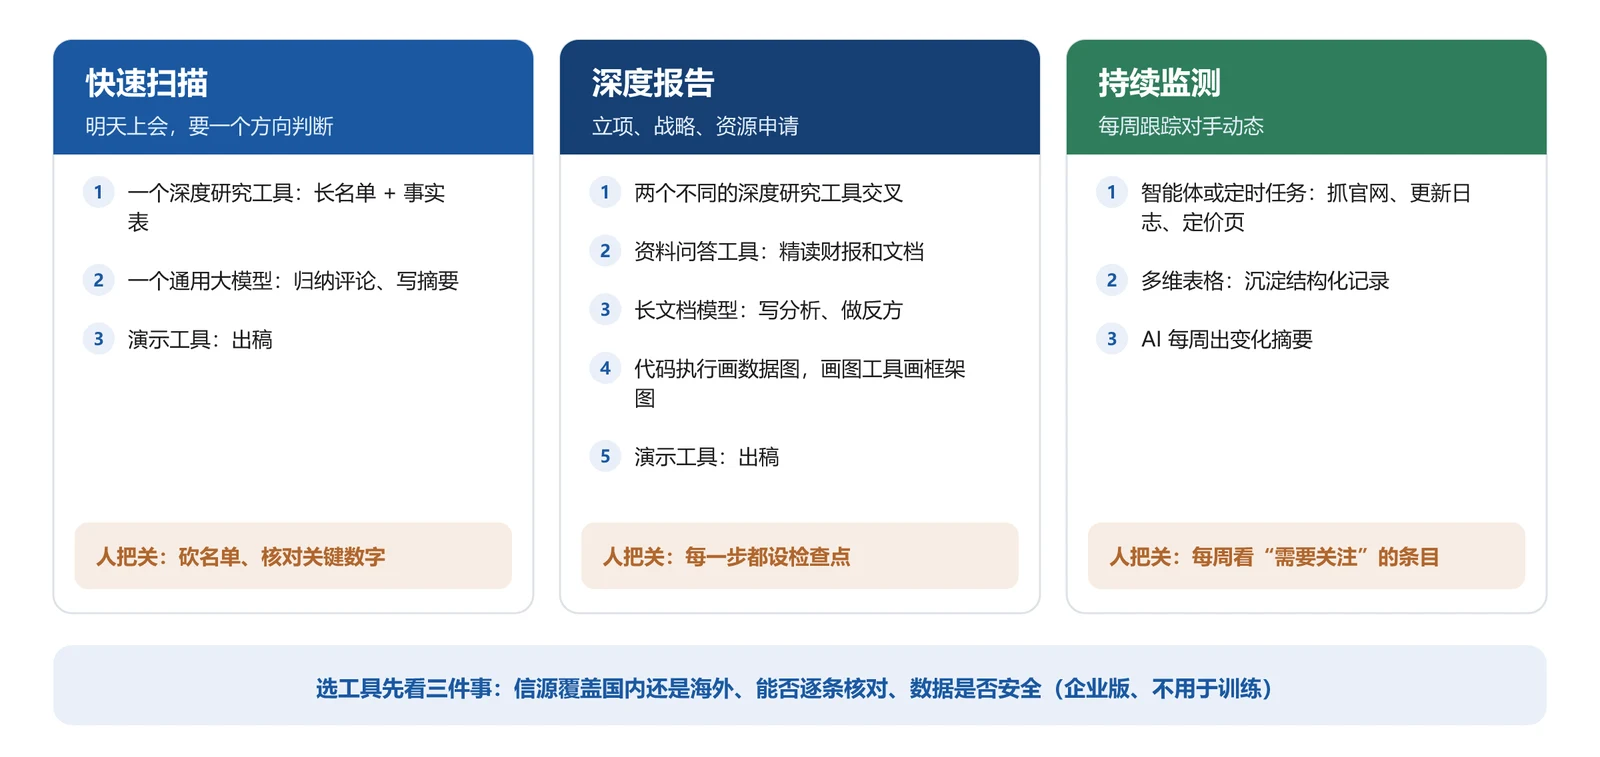
图 7 三种常见场景的工具组合与人工把关点
起步时不必追求工具多:先固定一个主力组合,把后面的八步工作流跑通,再按需要加工具。在公司里做,优先使用签了数据协议的企业版,公开版只处理公开信息。
四、写提示词:结构、角色与用途
(一)五段结构与四个技巧
好用的竞品分析提示词,大多由五段组成。其中四段是必需的,角色按需添加。
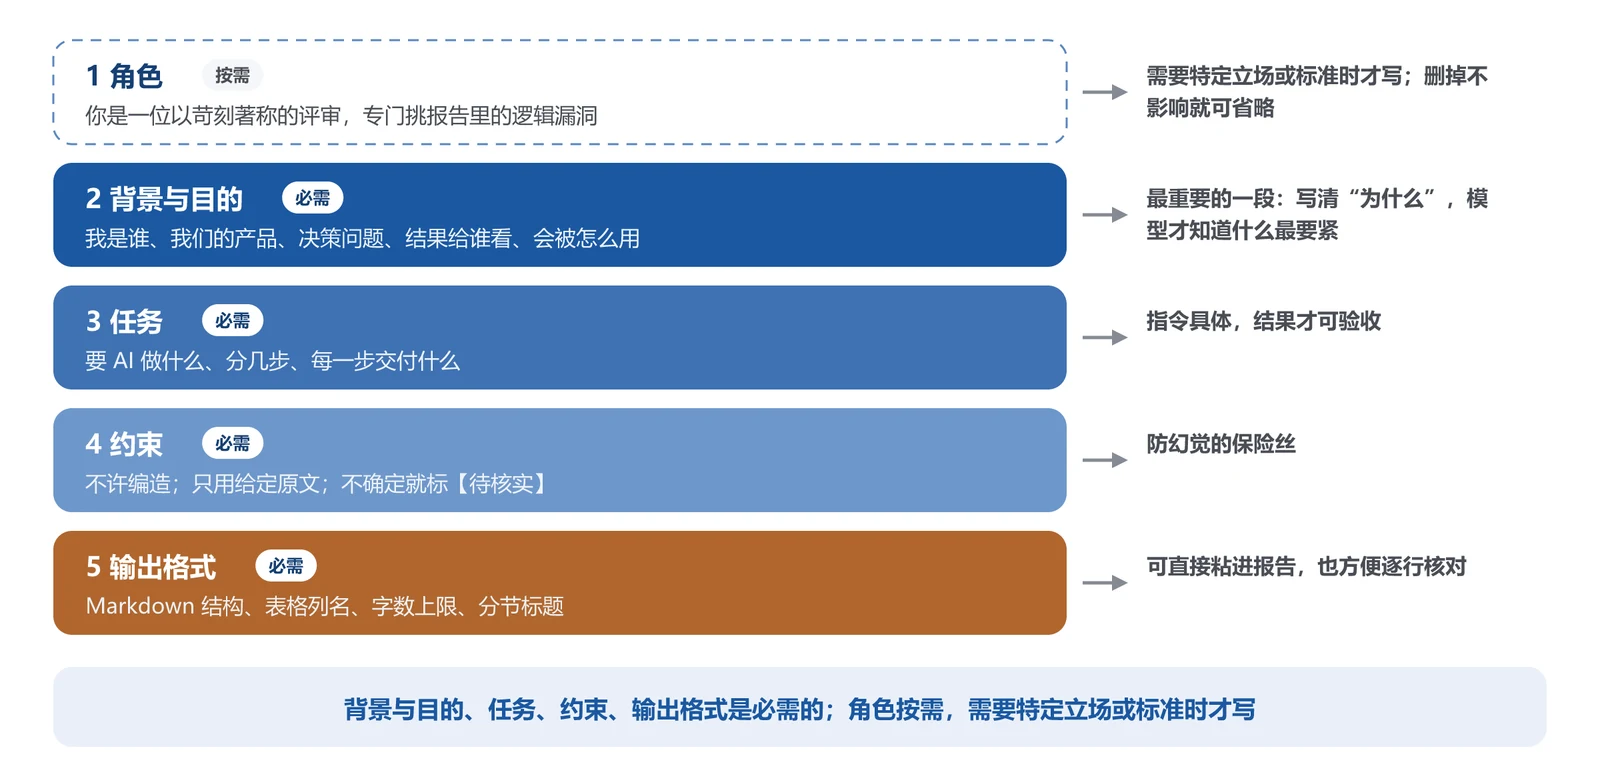
图 8 一条竞品分析提示词的五段结构:四段必需,角色按需
在这个结构之上,还有四个技巧最能提升输出质量:要求结构化输出(表格、固定列名),便于逐行核对;要求每条事实附来源链接和原文引述;明确允许它说“不知道”,查不到就写“未找到”;把事实和推测分开,推测统一放进“待验证假设”。
(二)角色:什么时候需要写
早期的提示词教程几乎都从“你是一位资深专家”开始,现在各家官方文档的重点已经转向:把背景交代清楚,说明为什么要这样做。角色设定仍然是一种有效的技巧,但它本质上是背景信息的简写,并不是必需的。有研究测试了 160 多种角色设定,发现在事实类问答上,加角色并不能稳定提升准确率[13]。
所以要分三种情况看。当角色本身就是任务,比如让 AI 当反方挑刺、扮演竞品负责人、做多角色推演,必须写,而且要写具体的立场,不要只写一个头衔;当你需要它用某种标准来评判(如“按审计的标准检查每个数字”),角色能带出这套标准,但直接把标准写出来效果更好;收集事实、整理信息这类任务,角色可有可无,加了不影响,背景、约束写清楚才是关键。一个简单的判断方法:把角色那一行删掉,看输出会不会变。
(三)用途:写清“为什么”,比多写规则管用
新一代模型会根据你给的目的来判断什么最要紧。比如在事实表的提示词里加一句“这张表会直接给老板看,每个数字都可能被追问来源”,比多写三条规则更能让它认真对待出处。后文每条提示词的“背景”里,都写了这样一句用途说明。
(四)不会写提示词?让 AI 帮你写
写好一条提示词并不容易,大部分人也没必要从零写,可以让 AI 帮你写。要点只有一个:别让它凭空写,先让它采访你。 凭空写出来的,往往是一个看起来完整、却不贴合你业务的通用模板。
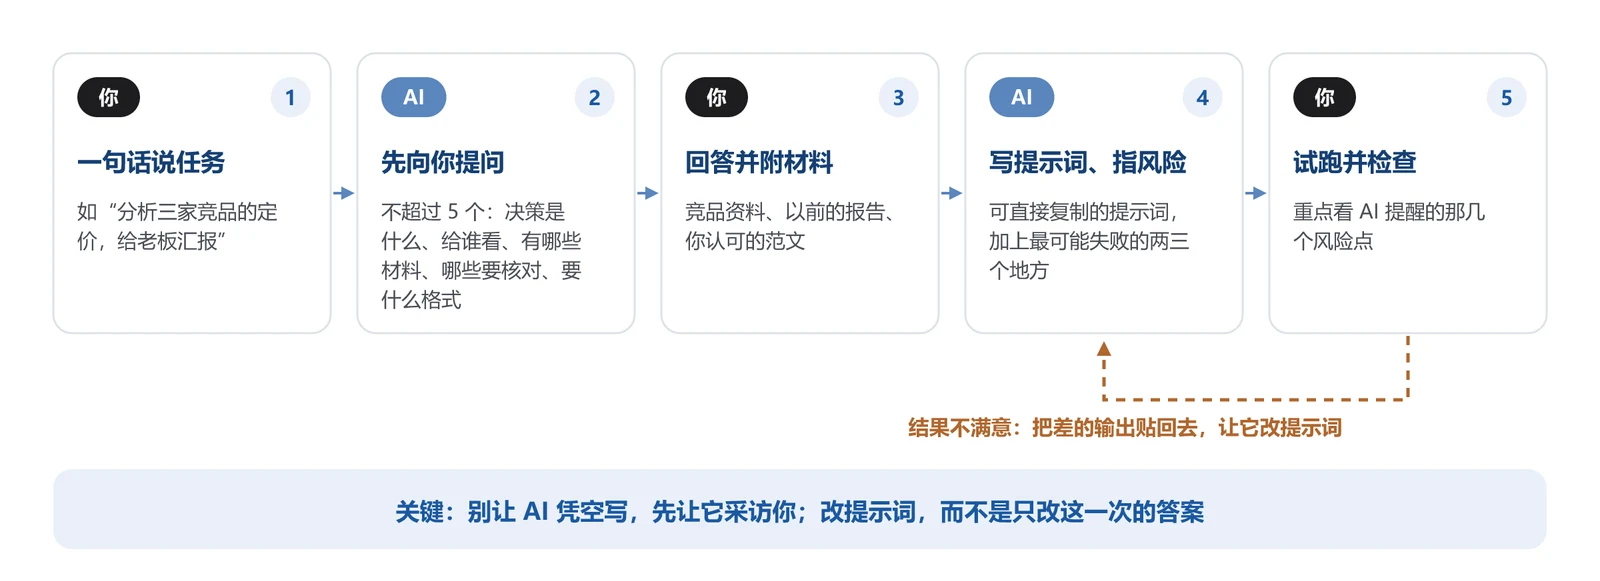
图 9 让 AI 帮你写提示词的五步流程
下面这条可以直接复制使用,把第一行换成你要做的事即可:
⓪ 让 AI 帮你写提示词

我想让 AI 帮我完成一件事:【一句话描述,例如“分析三家竞品的定价策略,给老板做汇报”】。
请你当我的提示词顾问,按下面三步来:

1. 先问我问题,不超过 5 个,弄清楚:这件事要支持什么决策、结果给谁看、我手上有哪些材料、哪些内容必须能核对来源、我想要什么样的输出。一次问完,等我回答后再继续。

2. 根据我的回答,写一条可以直接复制使用的提示词,包含:
   - 背景与目的:写明为什么做这件事、结果会被怎么用
   - 具体任务:分几步,每一步交付什么
   - 约束:不许编造;查不到就写“未找到”;事实和推测分开
   - 输出格式:用什么结构,表格有哪些列
   如果任务需要某种特定的立场或评判标准,再加上角色设定,并告诉我为什么加。

3. 写完后告诉我:这条提示词最可能在哪两三个地方失败,我拿到结果时应该重点检查什么。
用的时候有三个技巧。第一,把材料一起给它:竞品资料、以前写过的报告、你觉得写得好的范文,有参照,它写出的提示词会贴合得多。
第二,结果不满意时,把不好的输出贴回去,说清哪里不对,让它修改提示词本身,而不是只重写这一次的答案,这样提示词会越用越好。
第三,好用的提示词存下来,形成团队自己的提示词库,下次直接复用。主流模型的开发者平台(如 Anthropic 控制台、OpenAI Playground)也带有提示词生成和优化功能,原理与此相同。
五、八步工作流:每一步的提示词与检查点
把第一篇的六步流程展开成八步,每一步都有明确的 AI 动作、人工检查点和对应的提示词。
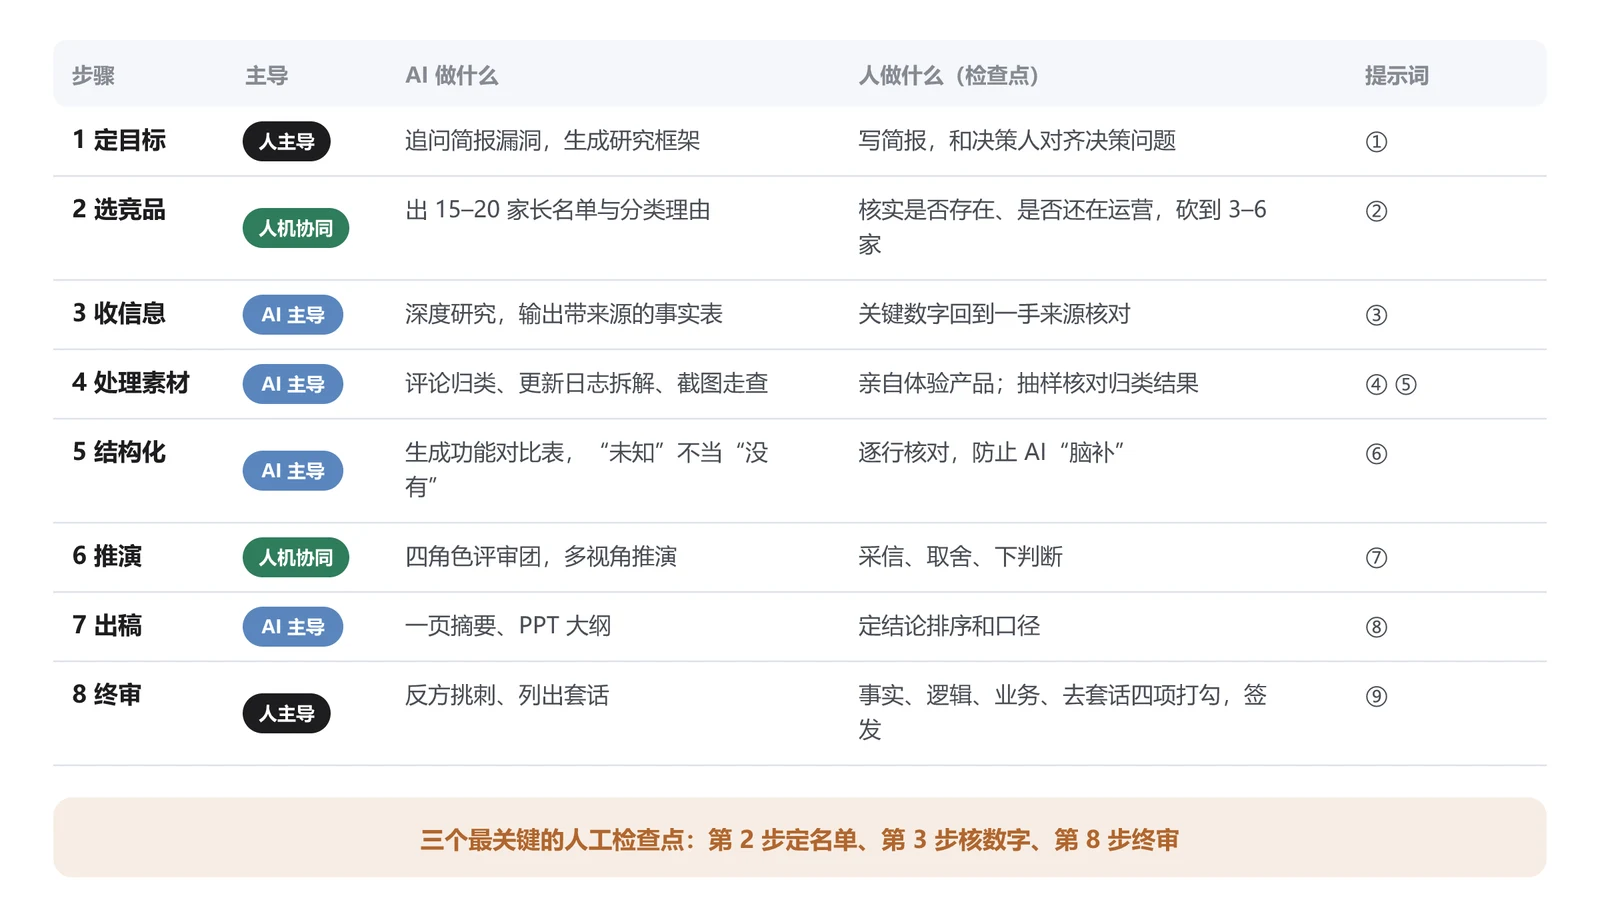
图 10 AI 辅助竞品分析的八步工作流。①到⑨是下文的提示词编号
下面逐步说明。提示词中方括号【】里的内容替换成你自己的信息。
第 1 步 定目标:先写简报,再让 AI 追问
不要丢给 AI 一句“帮我分析一下 X 赛道”。先自己写一页简报(第一篇的 8 个问题),把业务背景、决策问题、边界约束、资源限制写清楚,再让 AI 扮演严格的顾问,找漏洞、拆子问题、搭框架。
① 追问简报并生成研究框架

# 角色
你是一位有 10 年经验的产品战略顾问,擅长把模糊的业务问题拆成可执行的研究框架。

# 背景
我是【公司】的产品经理,我们在做【产品 / 赛道】。
本次竞品分析的决策问题是:【一句话,例如“我们下季度要不要做 X 功能”】。
听众是:【CEO / 业务负责人】。以下是我的分析简报:【粘贴简报】
这份框架决定了接下来收集什么信息,方向错了后面全白做,所以宁可多追问,也不要替我做假设。

# 任务
1. 先逐条追问:找出简报里模糊、缺失或自相矛盾的地方,每条附一句“为什么这会影响结论”;
2. 把决策问题改写成 3–5 个可以被回答的子问题;
3. 列出需要收集的信息维度,标注每个维度对本次决策的重要性(高 / 中 / 低);
4. 给出竞品分层标准(直接 / 间接 / 替代 / 潜在),每层 2–3 条判断标准,不要直接替我点名公司。

# 约束
不要给通用模板,要紧扣上面的决策问题;不确定的地方标【需你确认】,不要自行编造公司名。

# 输出格式
Markdown:## 追问清单 / ## 研究子问题 / ## 信息维度表 / ## 竞品分层标准
使用要点:第一遍可以先不填竞品真名,避免 AI 顺着名字套出现成的“分析模板”。
第 2 步 选竞品:AI 出长名单,人砍到 3–6 家
② 竞品长名单

# 角色
你是赛道研究员。

# 背景
这份名单用来决定深入分析哪几家。漏掉替代方案或新进入者,后面的结论就会出偏差;名单上的每一家我都会打开官网逐个核实。

# 任务
围绕【赛道关键词,例如“面向中小企业的智能客服”】生成竞品长名单:
1. 列出 15–20 家候选,覆盖国内头部、海外头部、新锐公司、平台型玩家和替代方案;
2. 每家一行:名称、官网链接、一句话定位、目标客群、近 6 个月最重要的一次动态;
3. 分类:直接竞品 / 间接竞品 / 替代方案 / 潜在进入者,并写明归类理由;
4. 每条“近期动态”标注【已核实】或【待核实】。

# 约束
不要写“行业内主要玩家包括……”这类空话;融资额、用户数、收入不确定就写“未公开 / 待核实”,不许估算;不确定是否存在或已停止运营的,标“待核实”。

# 输出格式
Markdown 表格:| 名称 | 官网 | 定位 | 客群 | 分类 | 近 6 个月动态 | 核实状态 |
使用要点:放在带联网能力的深度研究或 AI 搜索里跑。这一步是第一个人工检查点:AI 容易编造不存在的产品,或者推荐已经停服的产品。逐个打开官网核实,再按第一篇的“四圈 + 角色”砍到 3–6 家。
第 3 步 收信息:深度研究出“事实表”
这是最核心的一条提示词。目标不是让 AI 写一篇漂亮的报告,而是产出一张每行一条事实、每条都能回溯的事实表。
③ 事实表

# 背景
这张表会直接用在给【老板 / 决策人】的报告里,每个数字都可能被追问来源。所以宁可写“未找到”,也不要给出无法核对的内容。

# 任务
请就以下竞品收集事实:【竞品 A / B / C】。
维度:定价与套餐、目标客户、核心功能、最近 6 个月的重要更新、公开的用户规模或营收数据。

# 约束
1. 优先使用一手来源:官方文档、功能发布公告、定价页、财报;不要依赖第三方对产品功能的解读;
2. 只写有来源支持的内容,查不到就写“未找到”,不要推测;
3. 事实和观点分开:推测性内容统一放到最后的“待验证假设”;
4. 优先采用近 6 个月的信息;发布日期在 12 个月以前的,标注“可能过时”,并确认该情况至今是否仍然成立。

# 输出格式
表格,每行一条事实:| 竞品 | 维度 | 事实 | 来源链接 | 原文引述 | 发布日期 | 来源类型(官方 / 媒体 / 第三方数据 / 用户评论)|
用深度研究工具时,还有四个技巧值得掌握:
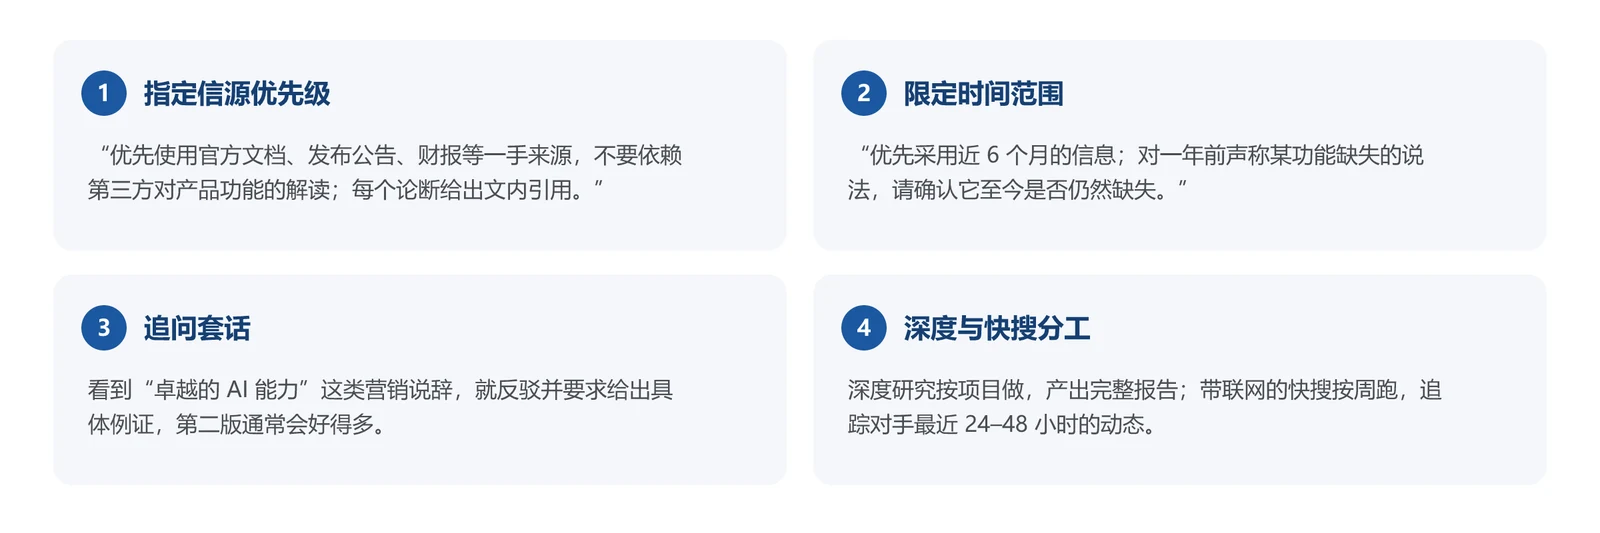
图 11 深度研究类工具的四个使用技巧
拿到事实表后是第二个人工检查点:关键数字必须回到一手来源核对,其余内容至少抽查一部分。凡是会出现在给决策人结论页上的事实,都要由人亲自打开原文确认过。
第 4 步 处理素材:评论归类与体验走查
一手素材仍然要人亲自采集:注册竞品的免费和付费账号,跑通核心流程并截图,下载近一年的更新日志,从应用商店或第三方平台导出用户评论。AI 负责批量处理,纪律只有一条:AI 只归纳,不创造。
④ 用户评论归类

# 角色
你是用户研究分析师,擅长从大量应用商店评论里提炼结构化洞察。

# 背景
我们想知道用户真正卡在哪里、为什么离开,用来决定下季度优先改什么。

# 输入
下面是【竞品 A】的【约 300 条】评论,含评分、日期和原文。

# 任务
1. 按“用户想完成什么任务”和“卡在哪里”两条线归类,归纳 6–10 个高频主题;每个主题给出条数、占比、平均评分倾向、2–3 条代表性原文;
2. 把负面主题按“痛点强度 × 出现频次”排序;
3. 区分“功能缺失”的抱怨和“功能有但做得不好”的抱怨,两类对产品的含义不同;
4. 单独列出用户主动提到的其他产品:他们从哪里来、想换到哪里去;
5. 标出最近 3 个月明显变多的抱怨;最后给 3 条对我们的启示,每条都要能追溯到上面某个主题。

# 约束
不许编造评论里没有的观点;某类评论少于 5 条时标注“样本不足,谨慎结论”;不要写“用户总体满意度较高”这类空话。

# 输出格式
## 主题归类表 / ## 痛点优先级 / ## 用户提到的其他产品 / ## 对我们的启示
⑤ 体验走查

# 背景
这份走查用来找出我们同一流程里可以减少或改掉的步骤。

# 输入
附件是【竞品 A】完成【核心任务,例如“新建会议纪要并分享给同事”】的逐步截图。

# 任务
按步骤记录:页面、用户操作、系统反馈、可能的卡点。
最后汇总:总步骤数、必填项数量、最容易流失的一步,以及与我们产品同一流程的差异。

# 约束
只依据截图描述,看不清的地方写“无法判断”,不要补充截图里没有的内容。
使用要点:评论一次控制在几百条以内,放进长上下文能力强的模型;归类结果要人工抽样核对,AI 常会把带讽刺语气的评论归错正负。更新日志也可以用同样的思路交给 AI,让它按时间线提炼对手战略重心的变化。
第 5 步 结构化:功能对比表,“未知”不等于“没有”
AI 在这一步最爱做的事是“脑补”:看到竞品 A 有某个功能,就推测竞品 B 应该也有,然后写进表里;或者把“官网没写”当成“竞品没有”。下面这条提示词专门防这两种错误。
⑥ 功能对比表

# 背景
这张表用来判断我们的差距和优先级。把“没找到”写成“不支持”,会让我们误判对手的短板,所以“未知”必须单独标出来。

# 输入
下面是我从【竞品 A / B / C】官网、帮助文档、更新日志里抓下来的原文,以及我们自家产品的功能清单。

# 任务
1. 生成功能对比表:行 = 按用户任务分组的功能项,列 = 我们 / A / B / C;
2. 单元格只允许写:完整支持 / 部分支持 / 不支持 / 未知;
3. 凡是“未知”,必须在表下注明“原文中未找到,需人工验证”,不许用“不支持”代替“未知”;
4. 表下加一节“口径差异”:哪些功能各家的定义不一样;
5. 标出 3–5 个“我们明显落后”和“我们明显领先”的格子。

# 约束
只用我给你的原文,不要联网补充;每条结论都能在原文中定位,用 [1][2] 标注出处。

# 输出格式
Markdown 表格 + 表下注 + 口径差异 + 领先 / 落后清单
记住第一篇的提醒:功能对比表只是素材,不构成分析。表格做完后,还要追问每个关键功能“它为什么做、效果如何、我们要不要做”。
第 6 步 推演:同一份事实,让四个角色各说一遍
只从一个视角写出来的竞品分析,很容易“两边都对、等于没说”。让 AI 扮演不同的利益相关方,是拓宽思路成本最低的办法:同一份事实材料,换四个角色各说一遍,再找共识和分歧。
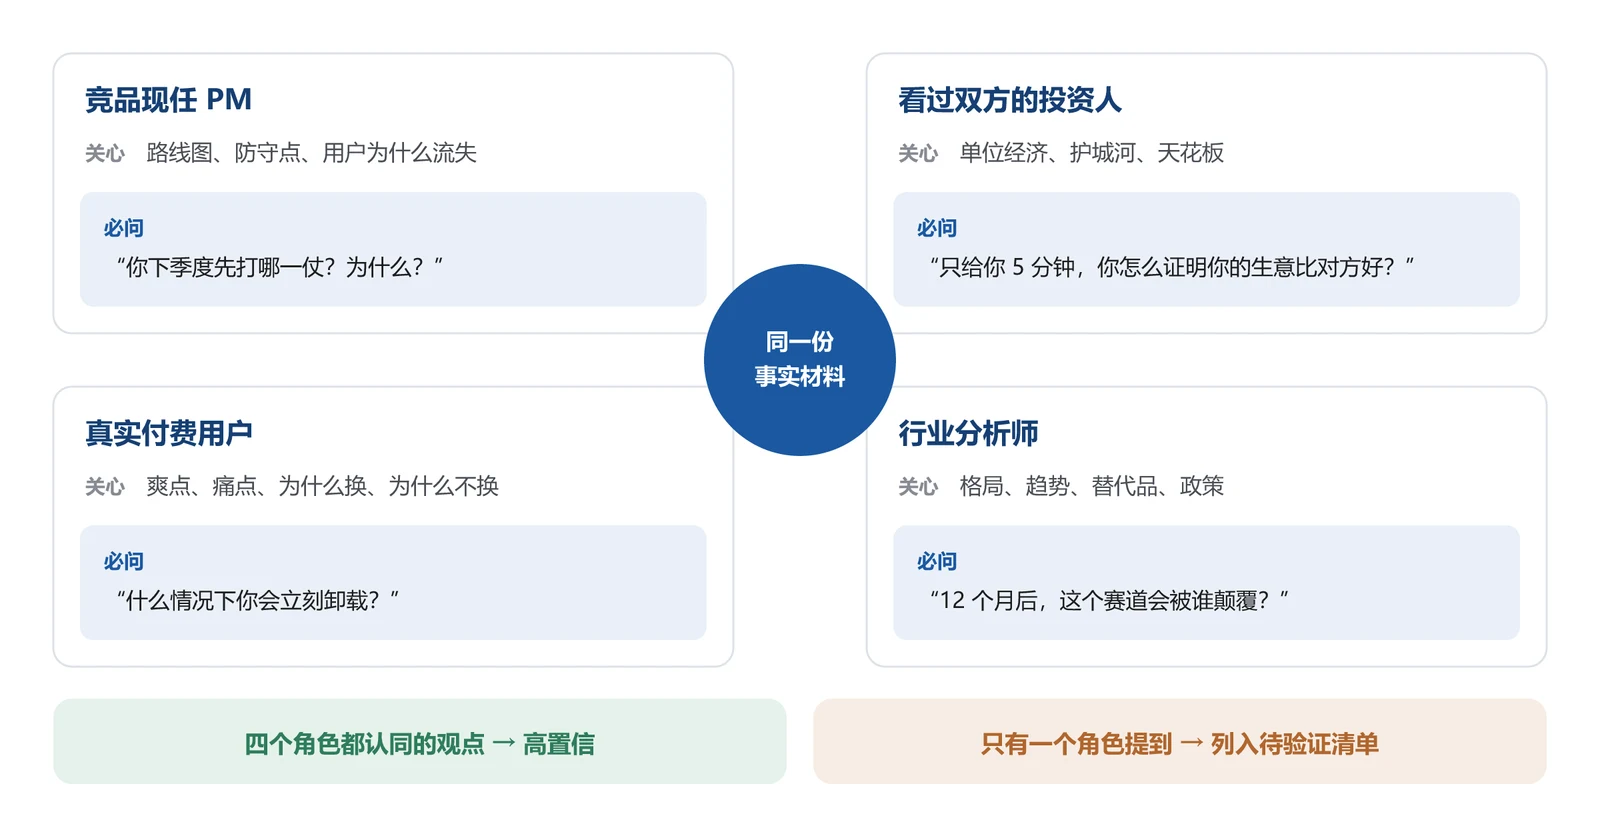
图 12 四角色评审团:同一份事实,四个立场
⑦ 四角色评审团

# 角色
你是一支模拟的评审团,由 4 个角色组成:
(1) 竞品公司的现任 PM;(2) 看过我们和竞品的投资人;(3) 一位真实的付费用户;(4) 行业分析师。

# 背景
我方产品:【一句话定位 + 核心客群 + 定价】;主要竞品:【A】。
这次推演的目的,是找出我们自己没想到的攻击点和机会,所以每个角色都要站稳自己的立场,不要互相迁就。
已掌握的事实(你只能基于这些事实推理,不要补充外部数据):
- 【事实 1】
- 【事实 2】
- 【事实 3】

# 任务
请分别以 4 个角色的口吻回答:
1. 你认为对方最大的 1 个优点和 1 个致命弱点是什么?
2. 如果你来做对方的下季度路线图,你会先打哪一仗?为什么?
3. 你会怎么攻击我方?
最后由你作为主持人总结:哪些观点是 4 个角色共同认可的(高置信),哪些只有 1 个角色提到(低置信,需要验证)。

# 约束
每个角色发言不超过 150 字,要像真人说话;不要输出“综合来看,双方各有优势”这类空话;明确区分【基于事实】和【合理推测】。

# 输出格式
按 4 个角色分节 + ## 高置信共识 + ## 低置信待验证
举个例子(示意)。在智能客服赛道,给定事实是“A 定价低但能力弱,B 能力强但价格高,我方居中”。竞品 PM 可能会说:“我们不会在模型能力上硬拼 B,会把‘三天上线’做到极致,吃中小客户的迁移预算。”投资人会说:“A 靠低获客成本撑着,一旦渠道收紧,增长会塌。”用户会说:“B 好用,但我要养一个两人团队才能把它用起来,这才是真贵。”分析师会说:“这个赛道的终局不是客服软件,而是工作流 Agent。”四个角色共同指向的“价格与能力错配”是高置信结论;只有分析师提到的“被 Agent 替代”,放进待验证清单,半年后回头检验。
推演结果由人筛选、采信、拍板。AI 不知道你的资源约束,最终判断必须由人来做。
第 7 步 出稿:一页摘要与汇报大纲
⑧ 摘要与 PPT 大纲

# 角色
你是资深战略顾问,擅长把长篇研究改写成高管 10 分钟能听完的汇报。

# 背景
听众是【CEO】,只有 10 分钟,要据此决定【……】。他会追问每一个关键数字,所以结论必须能直接追溯到初稿里的证据。

# 输入
下面是我们已经写完的竞品分析初稿。

# 任务
1. 提炼 1 页摘要:一句话结论 + 3 条支撑论据 + 2 个建议动作;
2. 把初稿改写成 10–12 页 PPT 大纲,每页给出:页面标题、3 个要点、建议的可视化形式;
3. 标出哪些页面的数据“必须在汇报前人工复核”;
4. 删掉“随着市场快速发展”“综上所述”这类套话,换成具体判断。

# 约束
每页标题必须是判断句(例如“A 的定价优势会在 12 个月内被 B 打穿”,而不是“A 定价分析”);不要新增初稿里没有的数字。

# 输出格式
## 一页摘要 / ## PPT 大纲(逐页)/ ## 汇报前必核清单
大纲生成后,可以交给 Gamma、Canva AI 或办公套件里的 AI 生成演示文稿。导出后同样要检查数字和版式。
第 8 步 终审:让 AI 当反方
定稿前最后一步,换一个新对话(避免 AI 维护自己写过的结论),让它专门挑刺。
⑨ 反方挑刺

# 角色
你是一位以苛刻著称的评审和风控顾问,专门挑报告里的逻辑漏洞。

# 背景
这份报告马上要交给决策人。宁可现在被你推翻,也不要上会后被问倒,所以请尽可能严厉。

# 输入
下面是这份竞品报告的结论与论据。

# 任务
逐条攻击:
1. 每条结论给出“最可能的 1 个反例”或“最可能被数据推翻的假设”;
2. 指出哪些结论是“把相关当因果”“幸存者偏差”“用单个事件推出普遍结论”;
3. 有没有被忽略的对手或替代方案;如果对手下个月做出某个动作,结论还成立吗?
4. 指出哪些句子是套话,给出更具体的改写;
5. 最后给一句诊断:如果这份报告错了,最可能错在哪里,怎样验证。

# 输出格式
## 逐条质疑 / ## 套话清单与改写 / ## 一句话诊断
反方的意见不一定都对,但每一条都要有回应:接受并修改,或者写明不采纳的理由。
六、风险与核验:四条红线
效率上去了,风险也跟着来了。下面四条是红线,任何时候都不能碰。
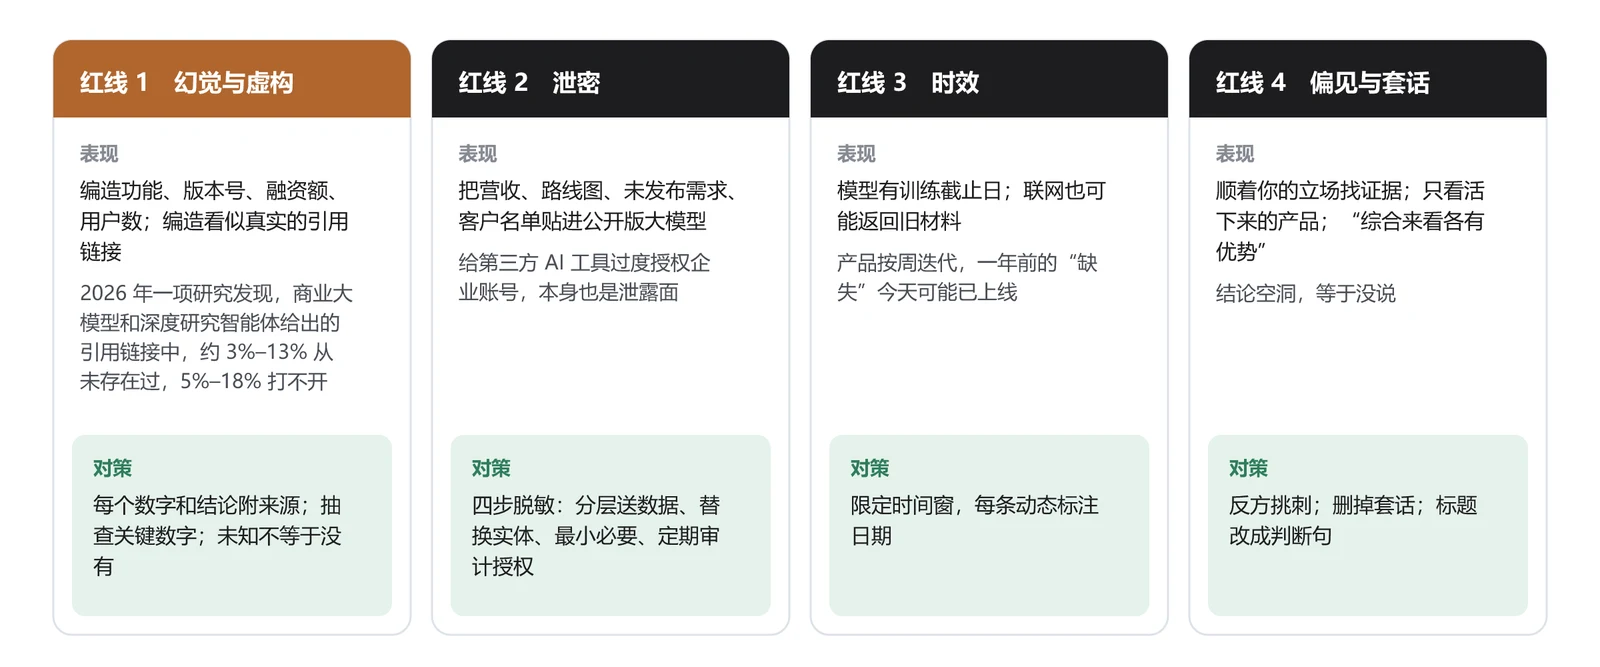
图 13 用 AI 做竞品分析的四条红线与对策
幻觉是最严重的一条。 它的典型表现有三种:编造不存在的功能、版本号、融资额、用户数;编造看似真实的引用链接;把“行业常识”说成“该公司官方数据”。这不是偶发故障,开头提到的研究已经量化过它出现的比例[4]。报告越长、引用越多,越容易让人放下戒心,这恰恰是最该小心的时候。
泄密同样不能碰。 公司未公开的营收、利润率、路线图、未发布需求、用户个人信息、客户名单、合同,都不要贴进公开版大模型。实操上可以用“四步脱敏”:分层送数据(公开版只喂公开信息,内部数据只走签了不训练条款的企业版或私有部署);替换实体(公司名换成“我方”“竞品 A”,具体数字换成区间);最小必要(只给完成任务所需的最小片段);定期审计授权(定期检查并收回给 AI 工具的企业账号授权,授权给得越多,泄露的口子就越多)。
时效和偏见则要靠提示词里的时间窗、每条动态标日期,以及终审时的反方挑刺来防。第三方数据平台的数字是抽样估算,跨工具口径不一致时,不要直接当结论用。
把这些要求固化成一条核验流水线,AI 初稿才能变成可以上会的报告:
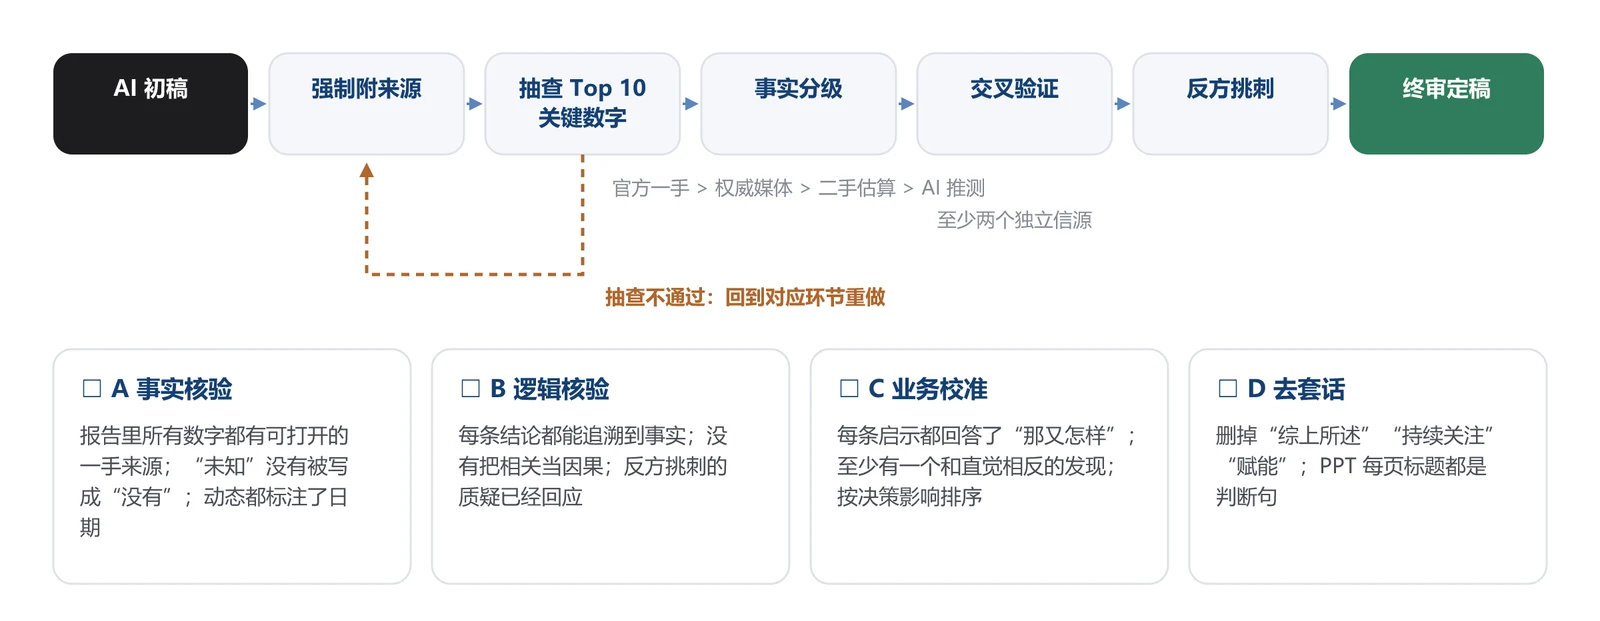
图 14 从 AI 初稿到终审定稿的核验流水线,以及终审前的四张打勾表
事实分级的规则很简单:官方一手 > 权威媒体 > 二手估算 > AI 推测,对外汇报只用前两类;关键数字至少有两个独立信源交叉验证。核验是整条链路里最不该省的一段:工具省下的时间,应该投回核验和洞察。
七、两个实践样本
(一)企业:把竞品分析做成持续运转的流水线
飞书官网发布过一个客户案例《AI 参谋进产品部:舒华体育用飞书实现竞品洞察提效》[6],思路是用多维表格和 AI 搭建竞品洞察流程,持续扫描友商的公开信息并沉淀为结构化数据。值得借鉴的不是具体用了哪个工具,而是两点:竞品分析从一次性项目变成了持续运转的流程;流程里保留了人工抽查点。
(二)个人:一天完成一次赛道扫描
假设老板临时要一份“中老年社交”赛道的快速扫描,第二天上会。按本文的工作流,可以这样走(示意):
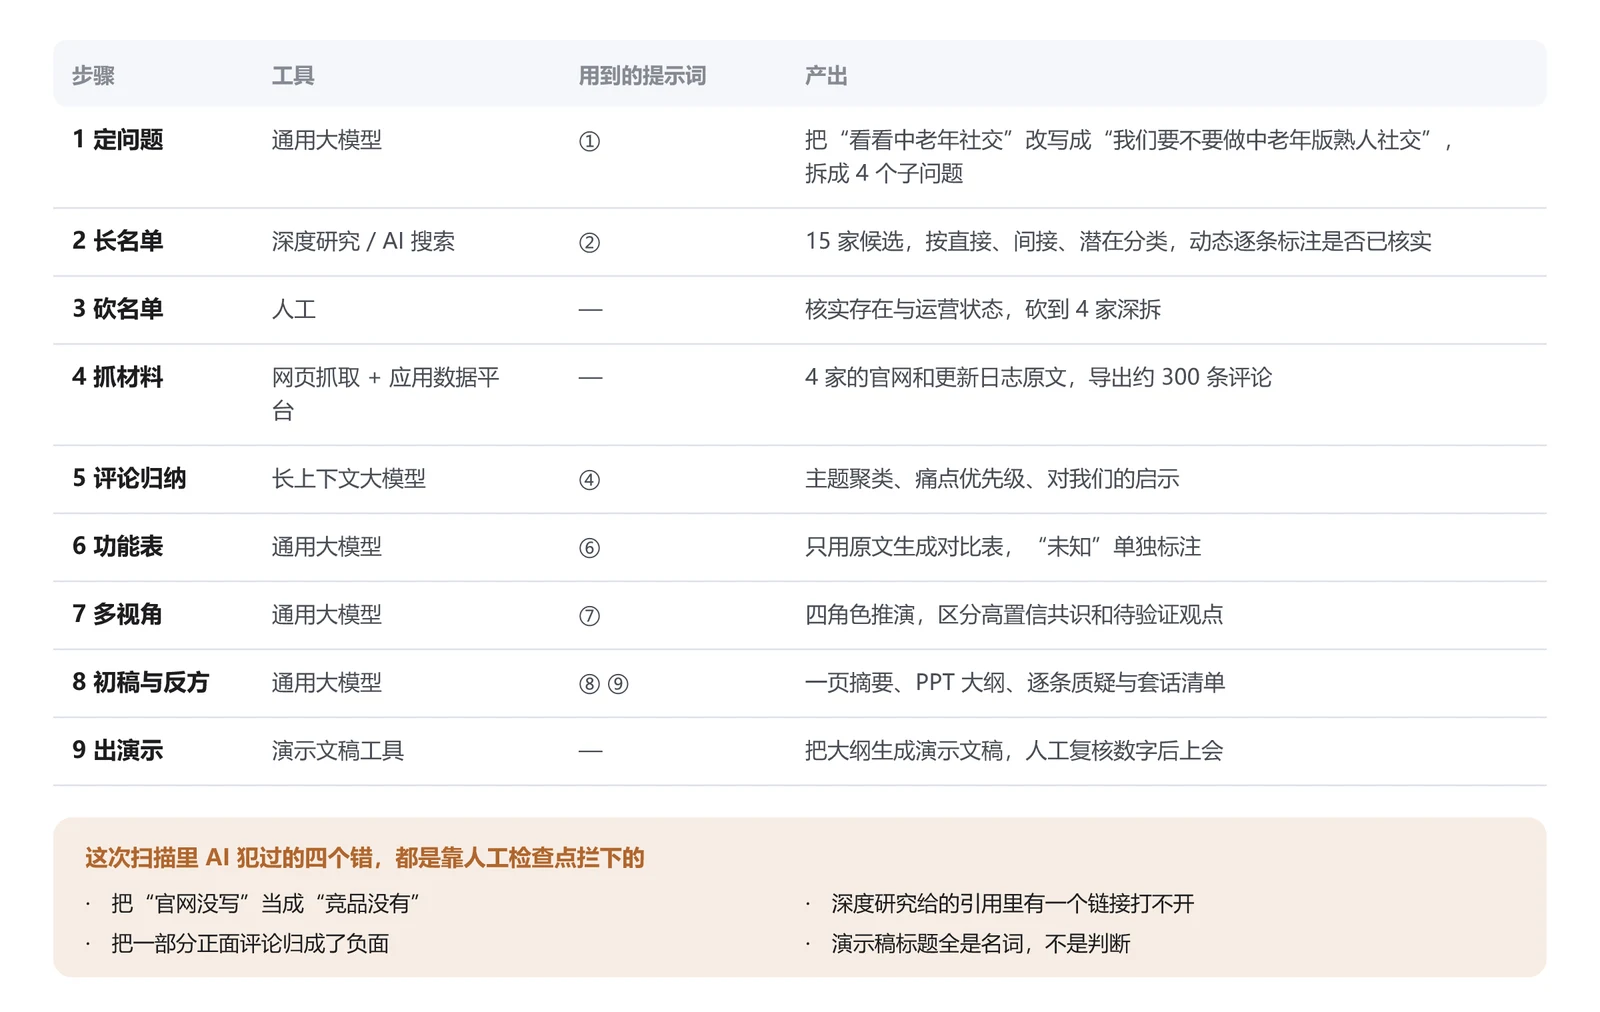
图 15 一次快速赛道扫描的步骤、工具与提示词(示意),以及被人工检查点拦下的四个错误
这类扫描用传统方式通常要几个工作日,用 AI 辅助可以压缩到一天以内。但图 15 下方拦下的四个错误也说明:人工核验和亲自补一手材料的时间不能省,否则就是拿着幻觉去汇报。
八、从一次性报告到持续情报:三种节奏
过去竞品分析成本高,通常是一次性项目,一个季度甚至半年做一次。AI 把单次成本降下来之后,可以把它变成一套持续运转的机制。
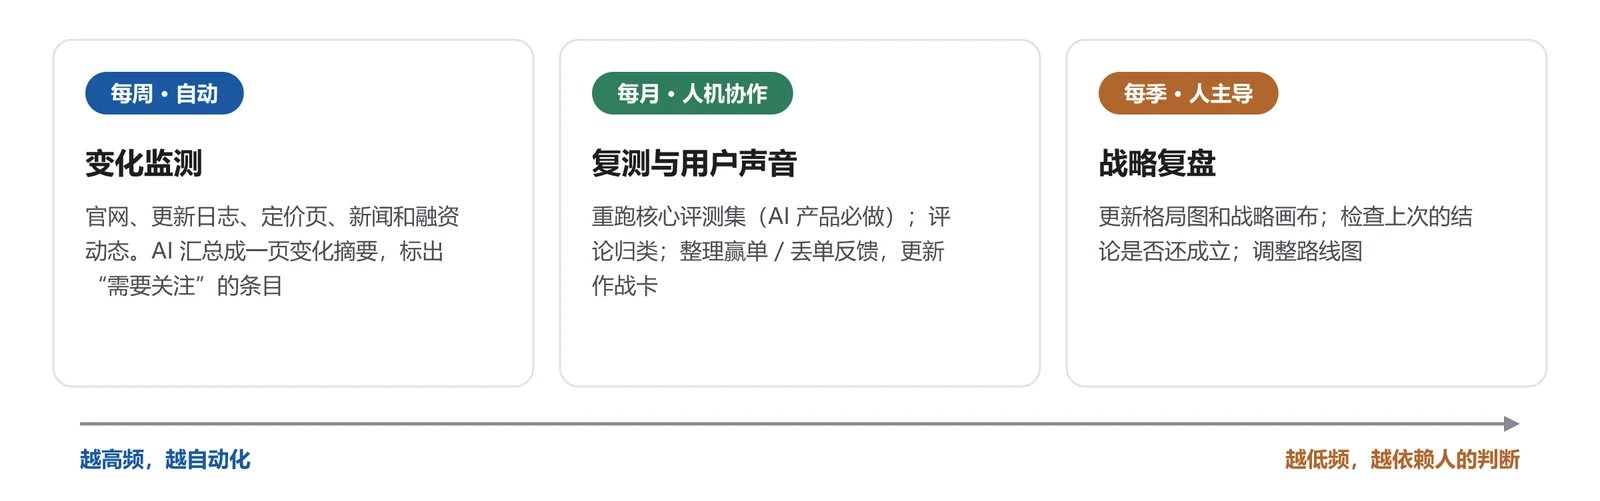
图 16 竞品情报的三种节奏:越高频越自动化,越低频越依赖人的判断
每周的变化监测完全可以交给定时任务和 AI 摘要;每月的评测复测和用户声音整理由人机协作完成;每季度的战略复盘必须由人主导。工具会不停迭代,今天的深度研究明天会有更强的替代品,但“定目标、辨事实、出洞察”这三件事,始终要由人来做。
结语
用 AI 做竞品分析,记住三句话就够了:
AI 干苦力,人做判断。 分工错了,报告就废了。
两条底线: 不喂内部数据,所有事实人工核验。
真正的壁垒是判断力。 AI 让每个人都能写出一份及格的竞品报告,拉开差距的,是问题问得准不准、有没有别人拿不到的一手数据,以及敢不敢下判断。
三篇到这里就讲完了:第一篇讲竞品分析怎么做,第二篇讲分析对象换成 AI 产品时要补什么,这一篇讲怎么用 AI 提效。下一次接到竞品分析任务时,先花十分钟想清楚目的,再决定怎么动手。
参考资料
- Google,《Try Deep Research and our new experimental model in Gemini》,2024-12-11,https://blog.google/products/gemini/google-gemini-deep-research/
- Computing,《OpenAI announces new AI agent for “deep research”》,2025-02(含 OpenAI 对局限性的说明),https://www.computing.co.uk/news/2025/ai/openai-announces-deep-research
- TechCrunch,《Perplexity launches its own freemium deep research product》,2025-02-15,https://techcrunch.com/2025/02/15/perplexity-launches-its-own-freemium-deep-research-product/
- Delip Rao、Eric Wong、Chris Callison-Burch,《Detecting and Correcting Reference Hallucinations in Commercial LLMs and Deep Research Agents》,arXiv:2604.03173,2026,https://arxiv.org/abs/2604.03173
- Manus,Wide Research 功能页,https://manus.im/zh-cn/features/wide-research
- 飞书客户案例,《AI 参谋进产品部:舒华体育用飞书实现竞品洞察提效》,https://www.feishu.cn/customers/shuhua_ai_case
- Columbia Journalism Review,Tow Center,《AI Search Has A Citation Problem》,2025-03,https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
- Anthropic,《How we built our multi-agent research system》,2025-06,https://www.anthropic.com/engineering/multi-agent-research-system
- Cognition,《Don’t Build Multi-Agents》,2025-06,https://cognition.com/blog/dont-build-multi-agents
- Cognition,《Multi-Agents: What’s Actually Working》,2026,https://cognition.com/blog/multi-agents-working
- Google,Gemini Canvas 与 Deep Research 功能说明,https://blog.google/products/gemini/gemini-collaboration-features/ ;https://gemini.google/overview/deep-research/
- Kimi(月之暗面)OK Computer 智能体模式介绍,https://en.wikipedia.org/wiki/Kimi_(AI) ;https://www.analyticsvidhya.com/blog/2025/10/kimi-ok-computer/
- Mingqian Zheng 等,《When “A Helpful Assistant” Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models》,Findings of EMNLP 2024,https://arxiv.org/abs/2311.10054
延伸阅读:
- 人人都是产品经理,《用 AI 工具 2 小时搞定竞品分析报告》,https://www.woshipm.com/ai/6206350.html
- 站酷,《用 AI 做竞品分析的真实体验》,https://www.zcool.com.cn/article/ZMTY4NTUyNA==.html
- Klue,《Bring win-loss into compete content》,https://klue.com/blog/bring-win-loss-into-compete-content
说明:文中工具仅作方法示例,不构成推荐,功能、额度与价格以各产品官网为准。标注“示意”的图表与例子用于说明方法,不代表任何产品的真实表现。所有配图的可编辑 SVG 源文件在 images/svg 目录下。